Det finns numera flera paket som tillåter snabb exploration av data. Paketet DataExplorer är skapat för att producera färdiga rapporter, alternativt delar av rapporter. Det finns flera snarlika paket men DataExplorer är väldokumenterat och inbegriper de viktigaste metoderna. Börja med att installera och aktivera paketet:
install.packages("DataExplorer")
library(DataExplorer)
DataExplorer kan skapa en formaterad rapport som sparas som en PDF-fil på hårddisken. För att göra detta används funktionen create_report() som har argumenten output_file (namnet på filen som sparas på hårddisken), report_title (titel på rapporten), och det frivilliga argumentet y. Argumentet y anges bara om deskriptionerna ska stratifieras på en variabel. I nedanstående kod stratifieras rapporten på kolumnen death, som indikerar om patienten avled under studien.
rhc %>%
  create_report(
    output_file="rapportfilens namn",
    report_title= "titel på rapporten",
    y="death"
  )
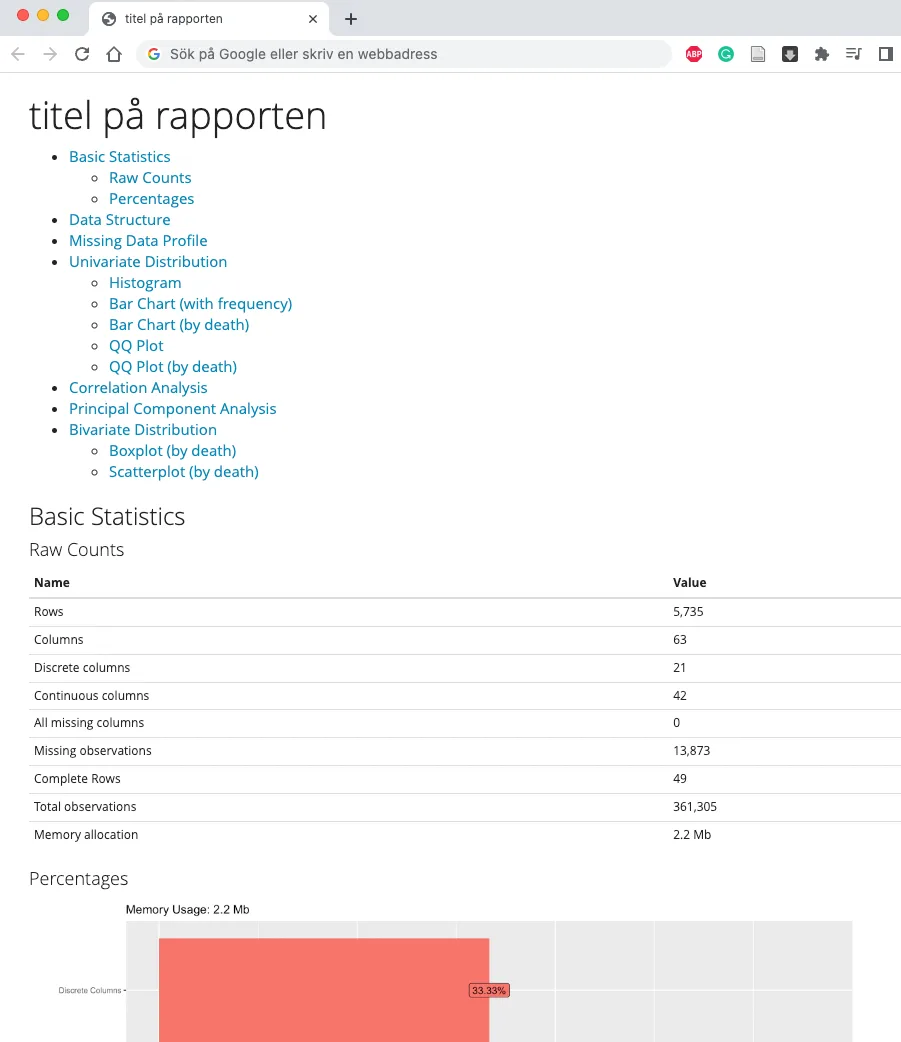
Därefter kommer filen (med formatet HTML) att finnas i din working directory. Om du inte vet var din working directory är så skriver du kommandot getwd(), vilket returnerar din working directory (sannolikt är det samma mapp som ditt R-skript finns i). Början av filen ser ut som följer:
Vi fortsätter med att demonstrera hur enskilda komponenter i rapporten kan produceras för att explorera data.
Börja med en övergripande beskrivning av data:
introduce(rhc)| rows | columns | discrete_columns | continuous_columns | all_missing_columns | total_missing_values | complete_rows |
|---|---|---|---|---|---|---|
| 5735 | 63 | 21 | 42 | 0 | 13873 | 49 |
plot_intro(rhc)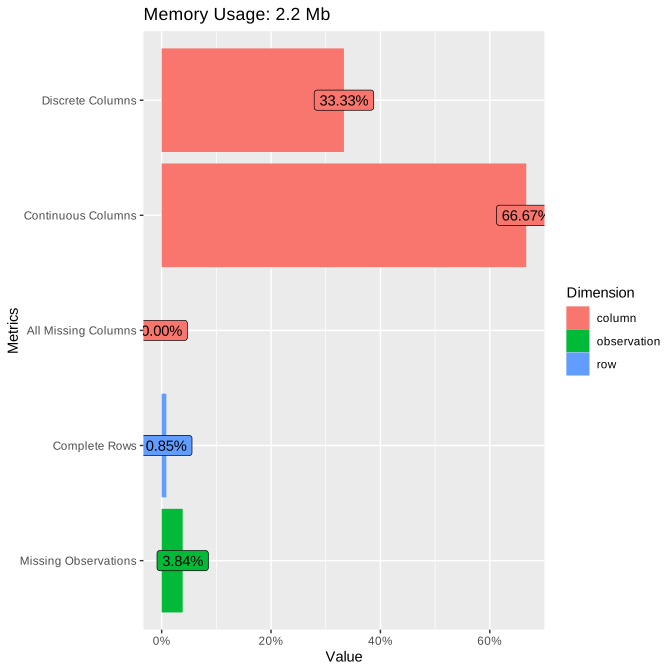
plot_missing(rhc)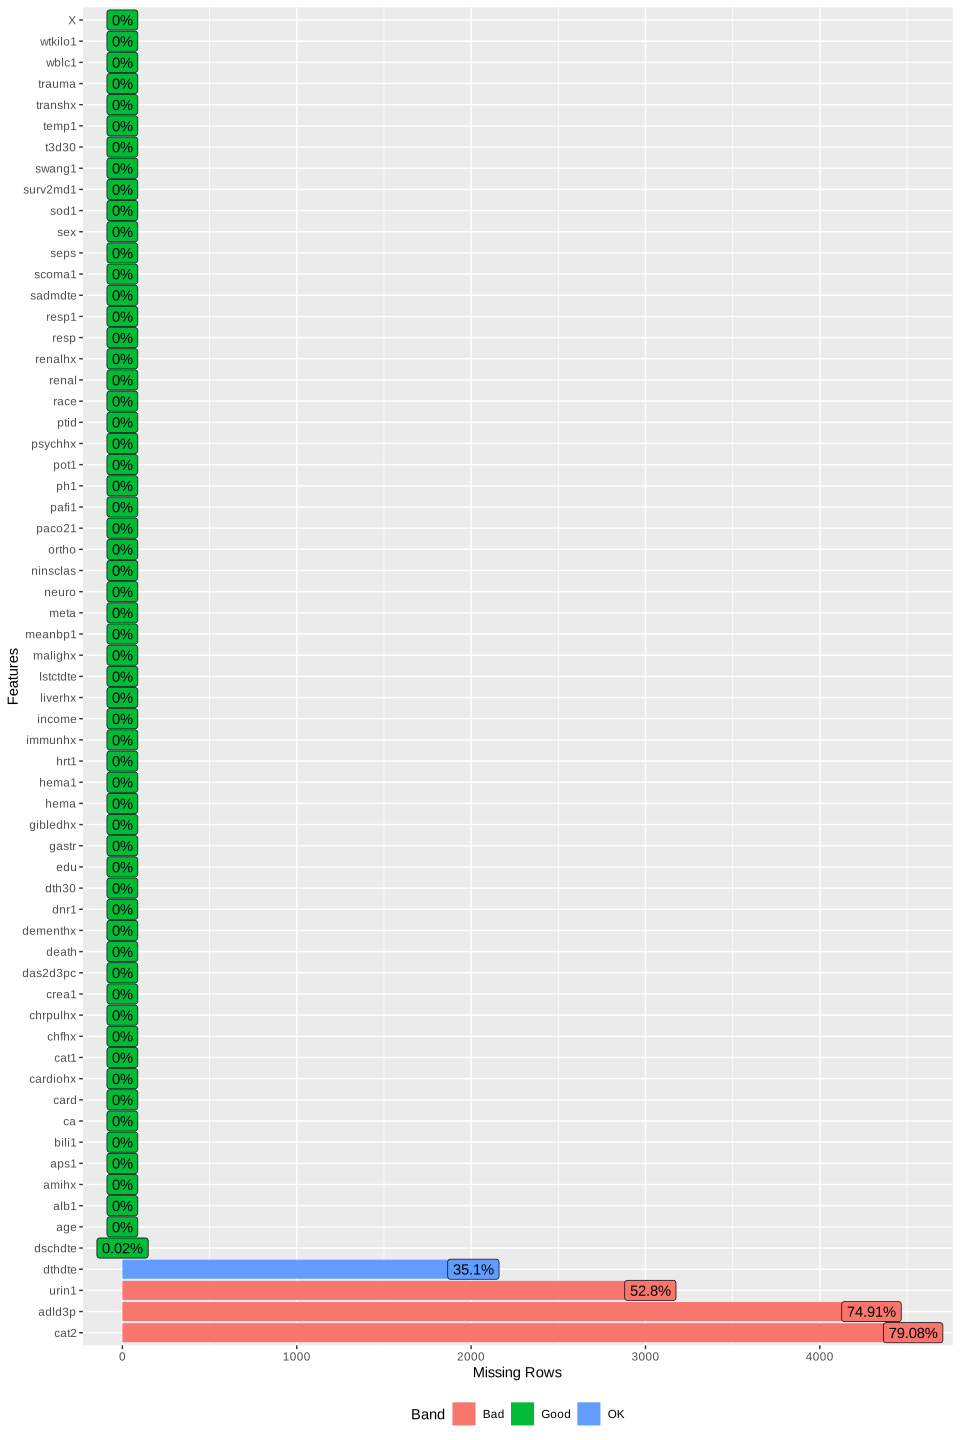
## Frekvenser stratifierat på en varibel
plot_bar(rhc, by = "death", nrow=20, ncol=4)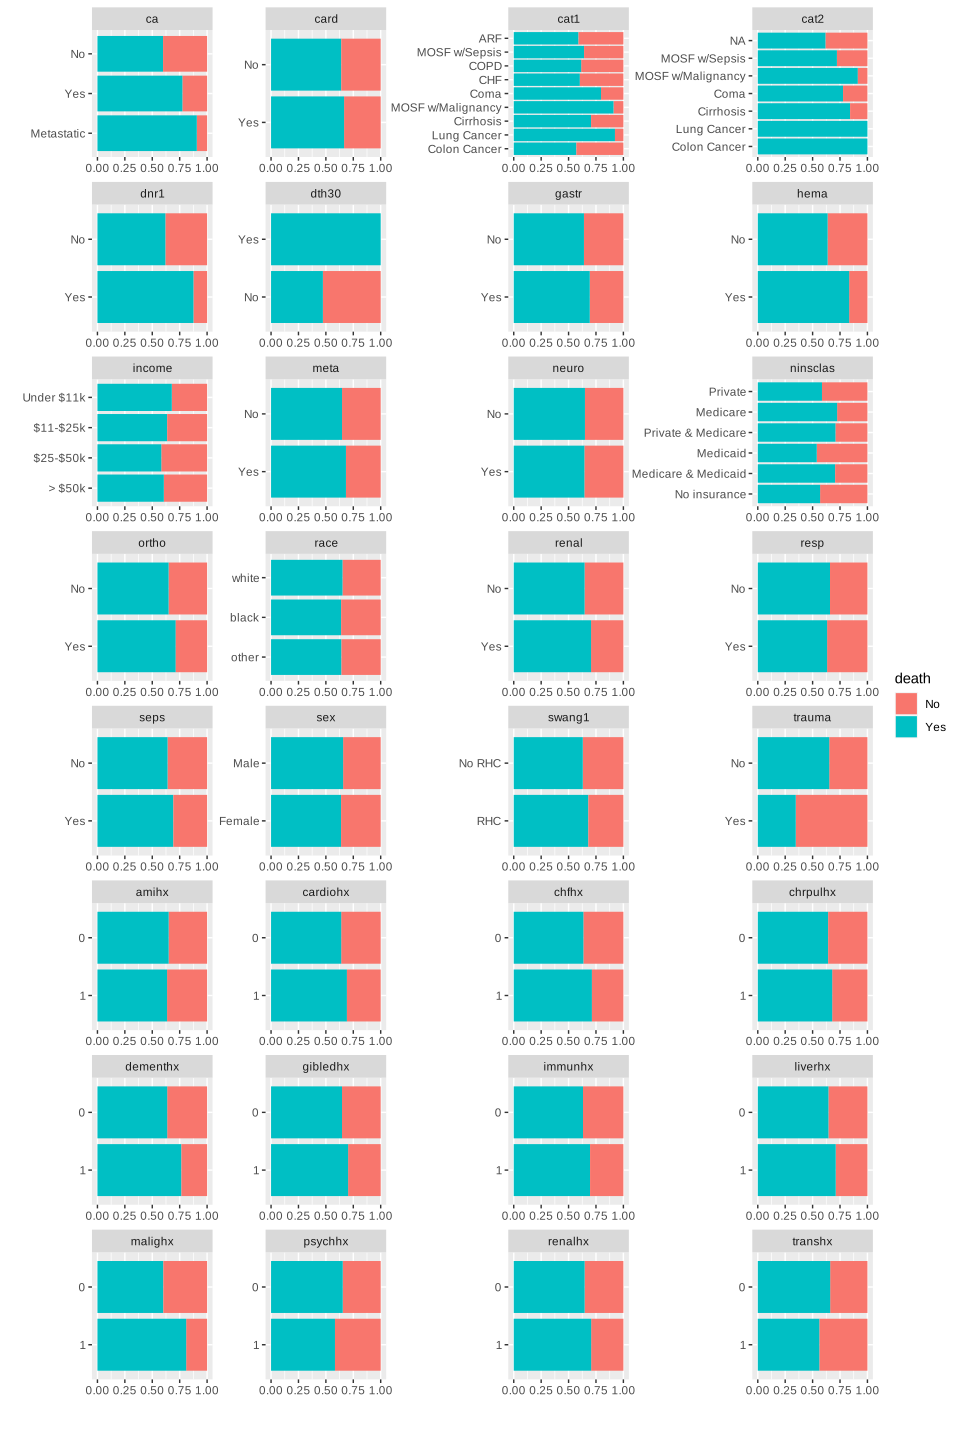
## Se histogram med alla kontinuerliga variabler
plot_histogram(rhc)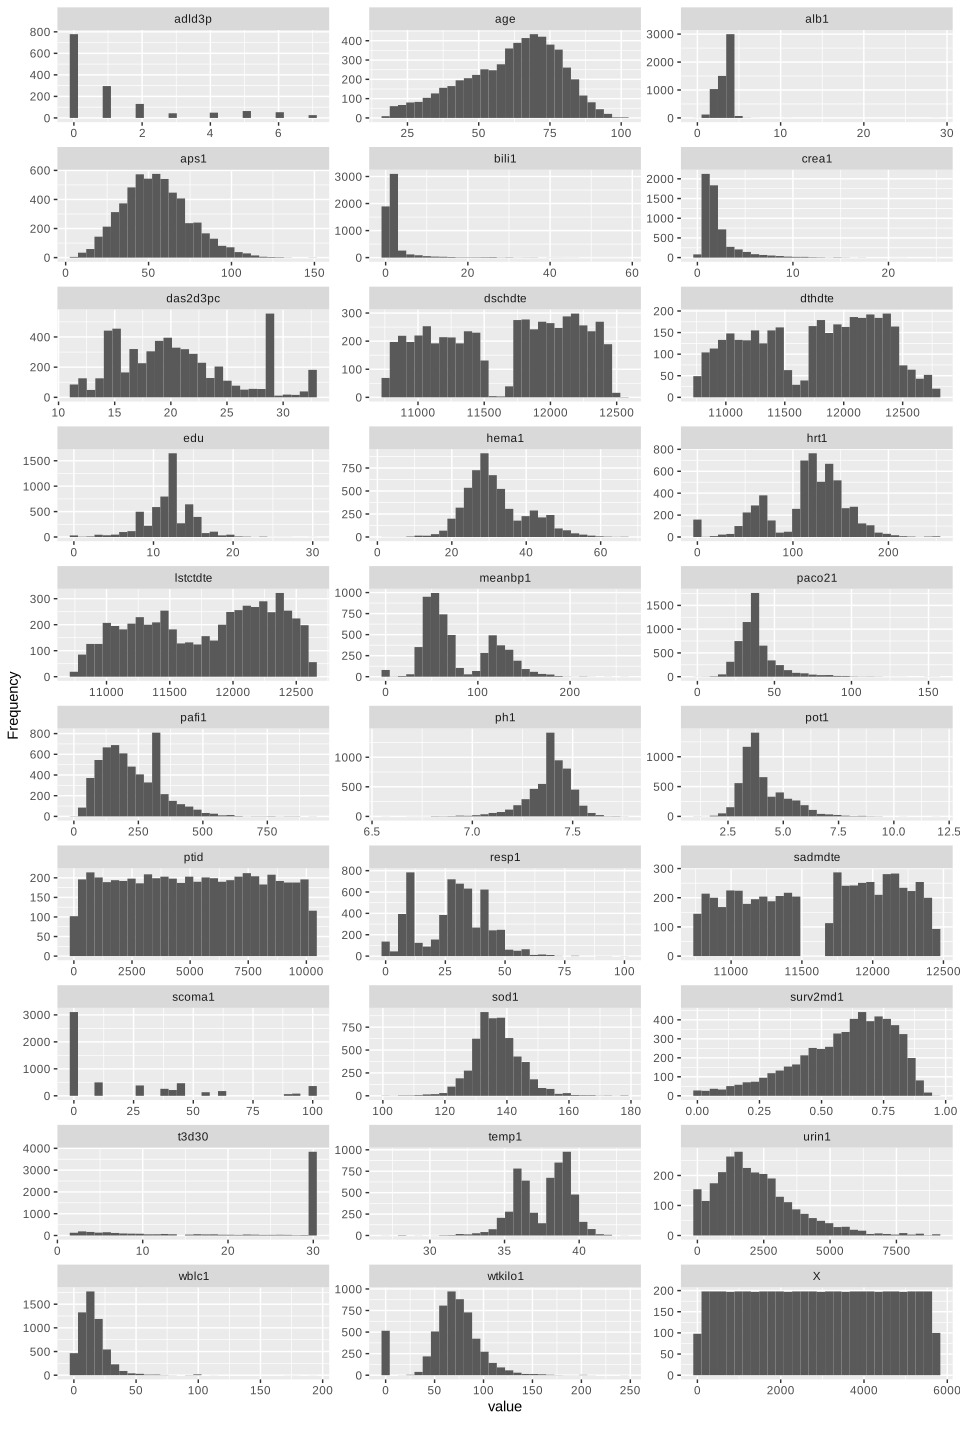
## Densitetskurvor för alla kontinuerliga variabler
plot_density(rhc, ncol=3, nrow=10)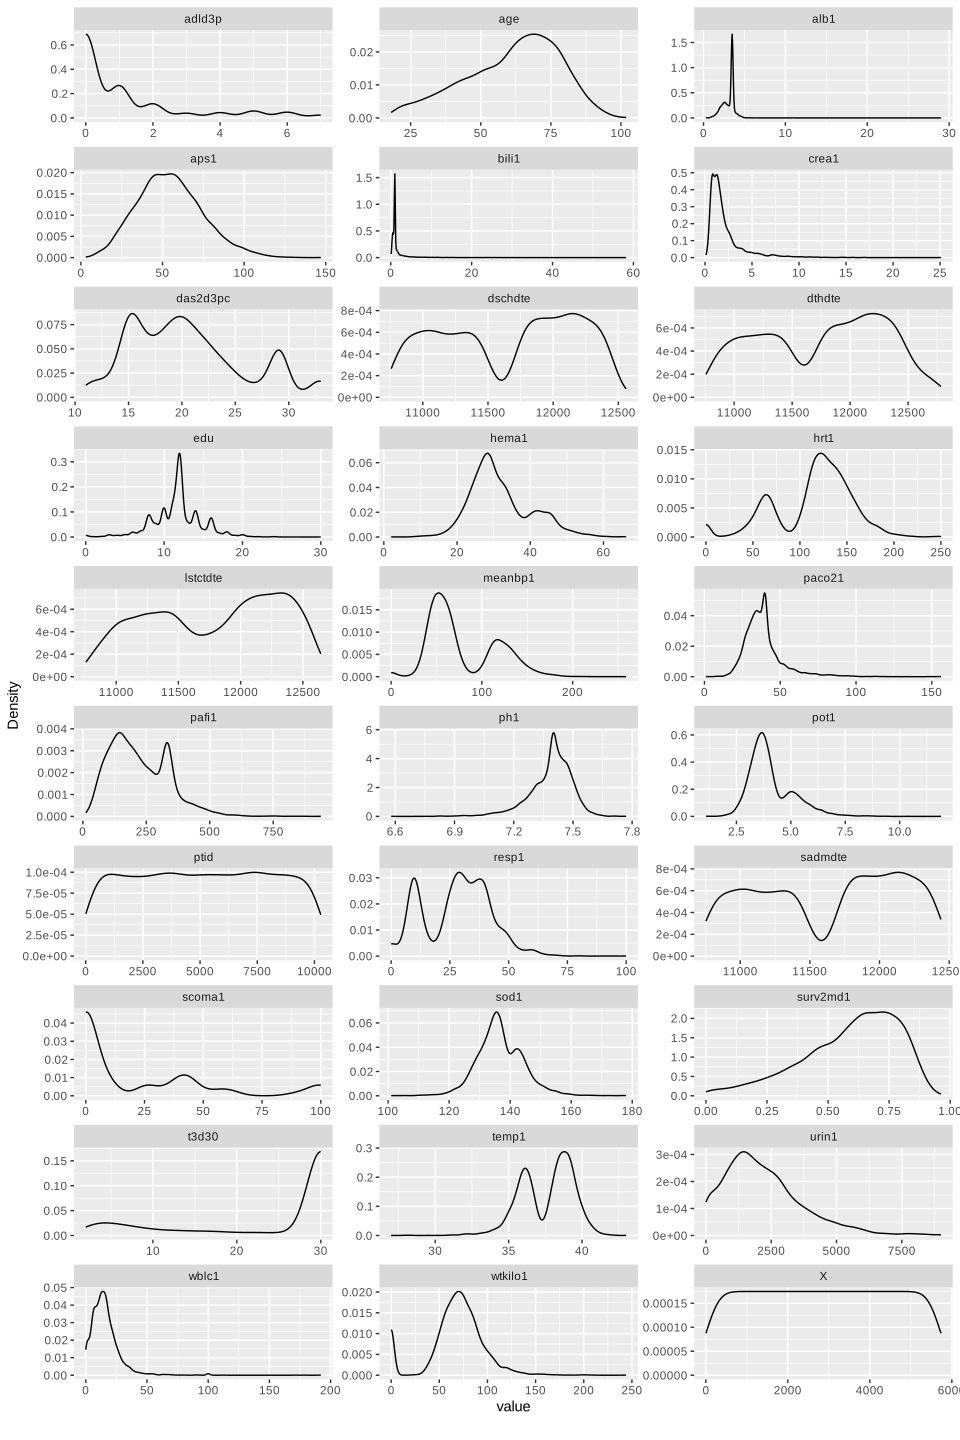
## QQ-grafer för alla kontinuerliga variabler
plot_qq(rhc, ncol=3, nrow=10)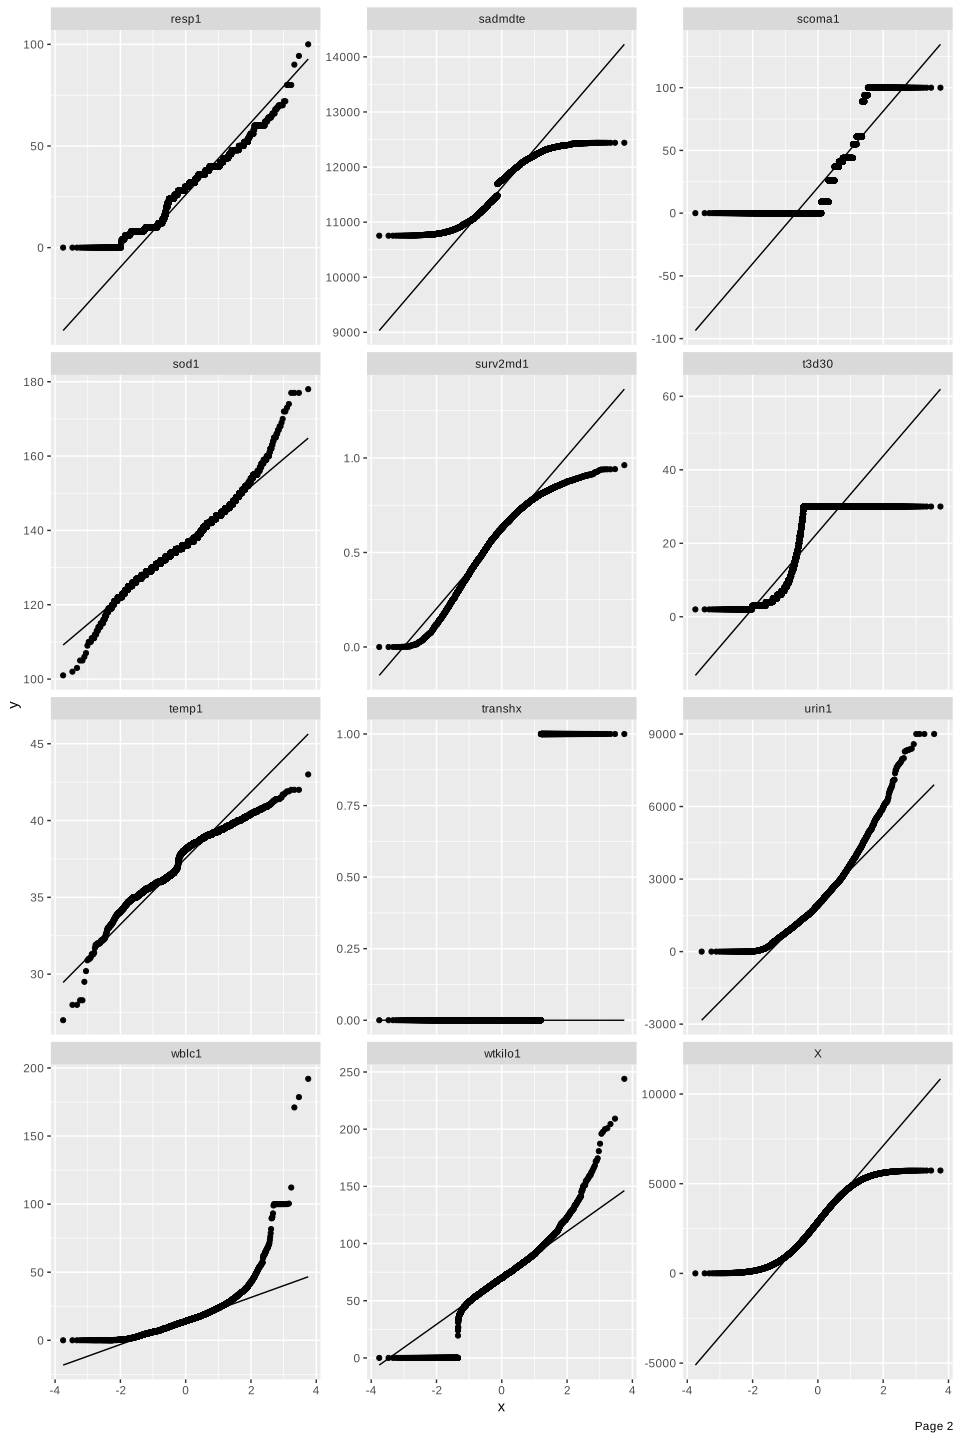
## QQ-grafer stratifierade på en kolumn
plot_qq(rhc, by = "death", ncol=3, nrow=10)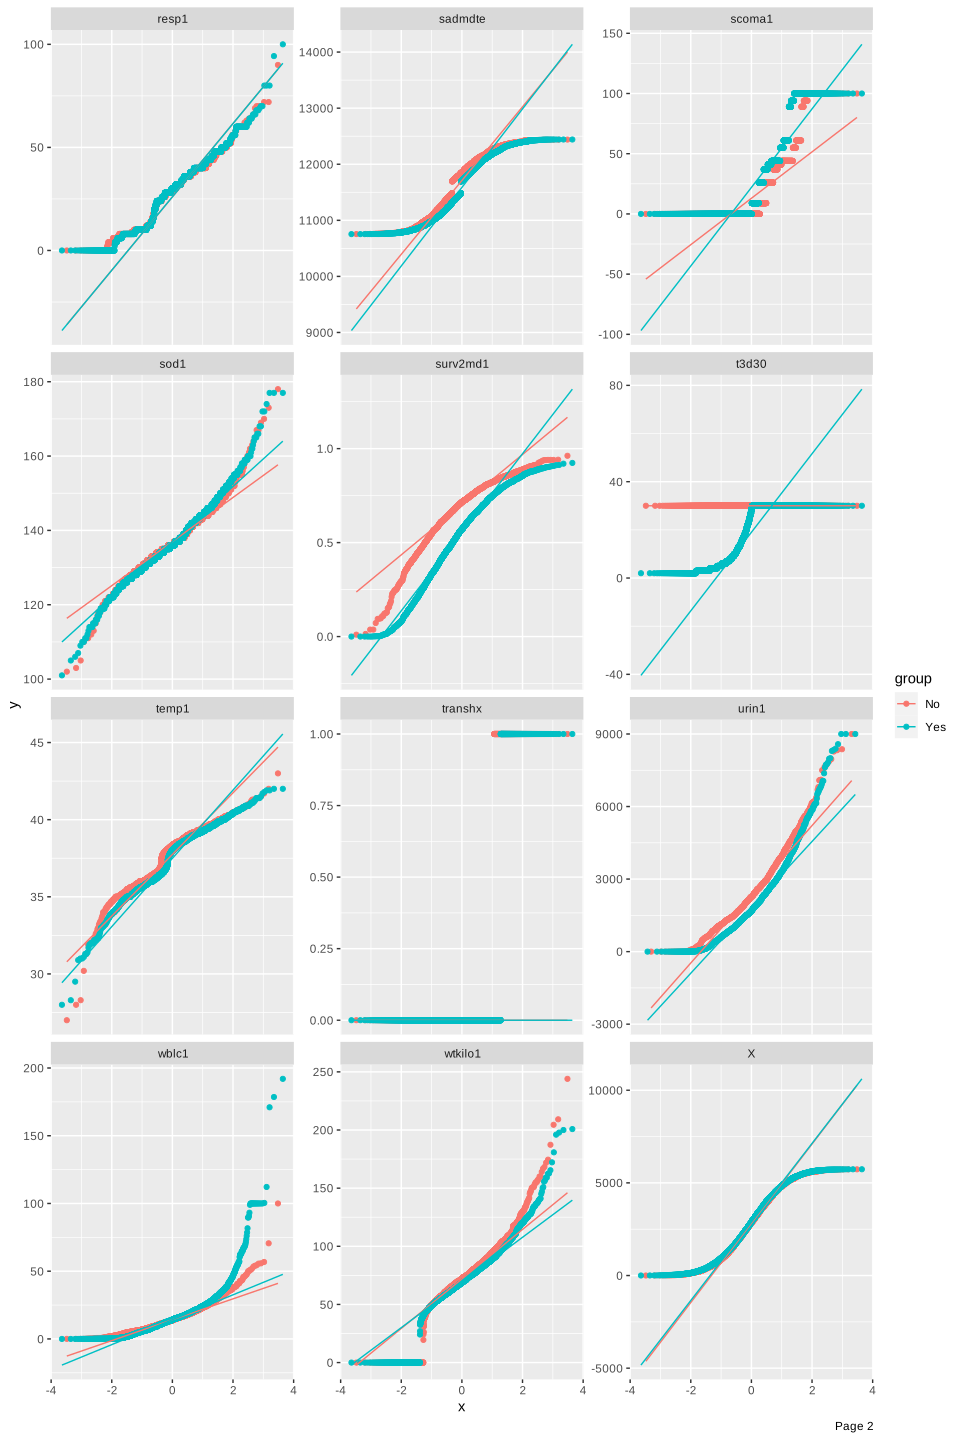
## Korrelationsmatriser
plot_correlation(rhc)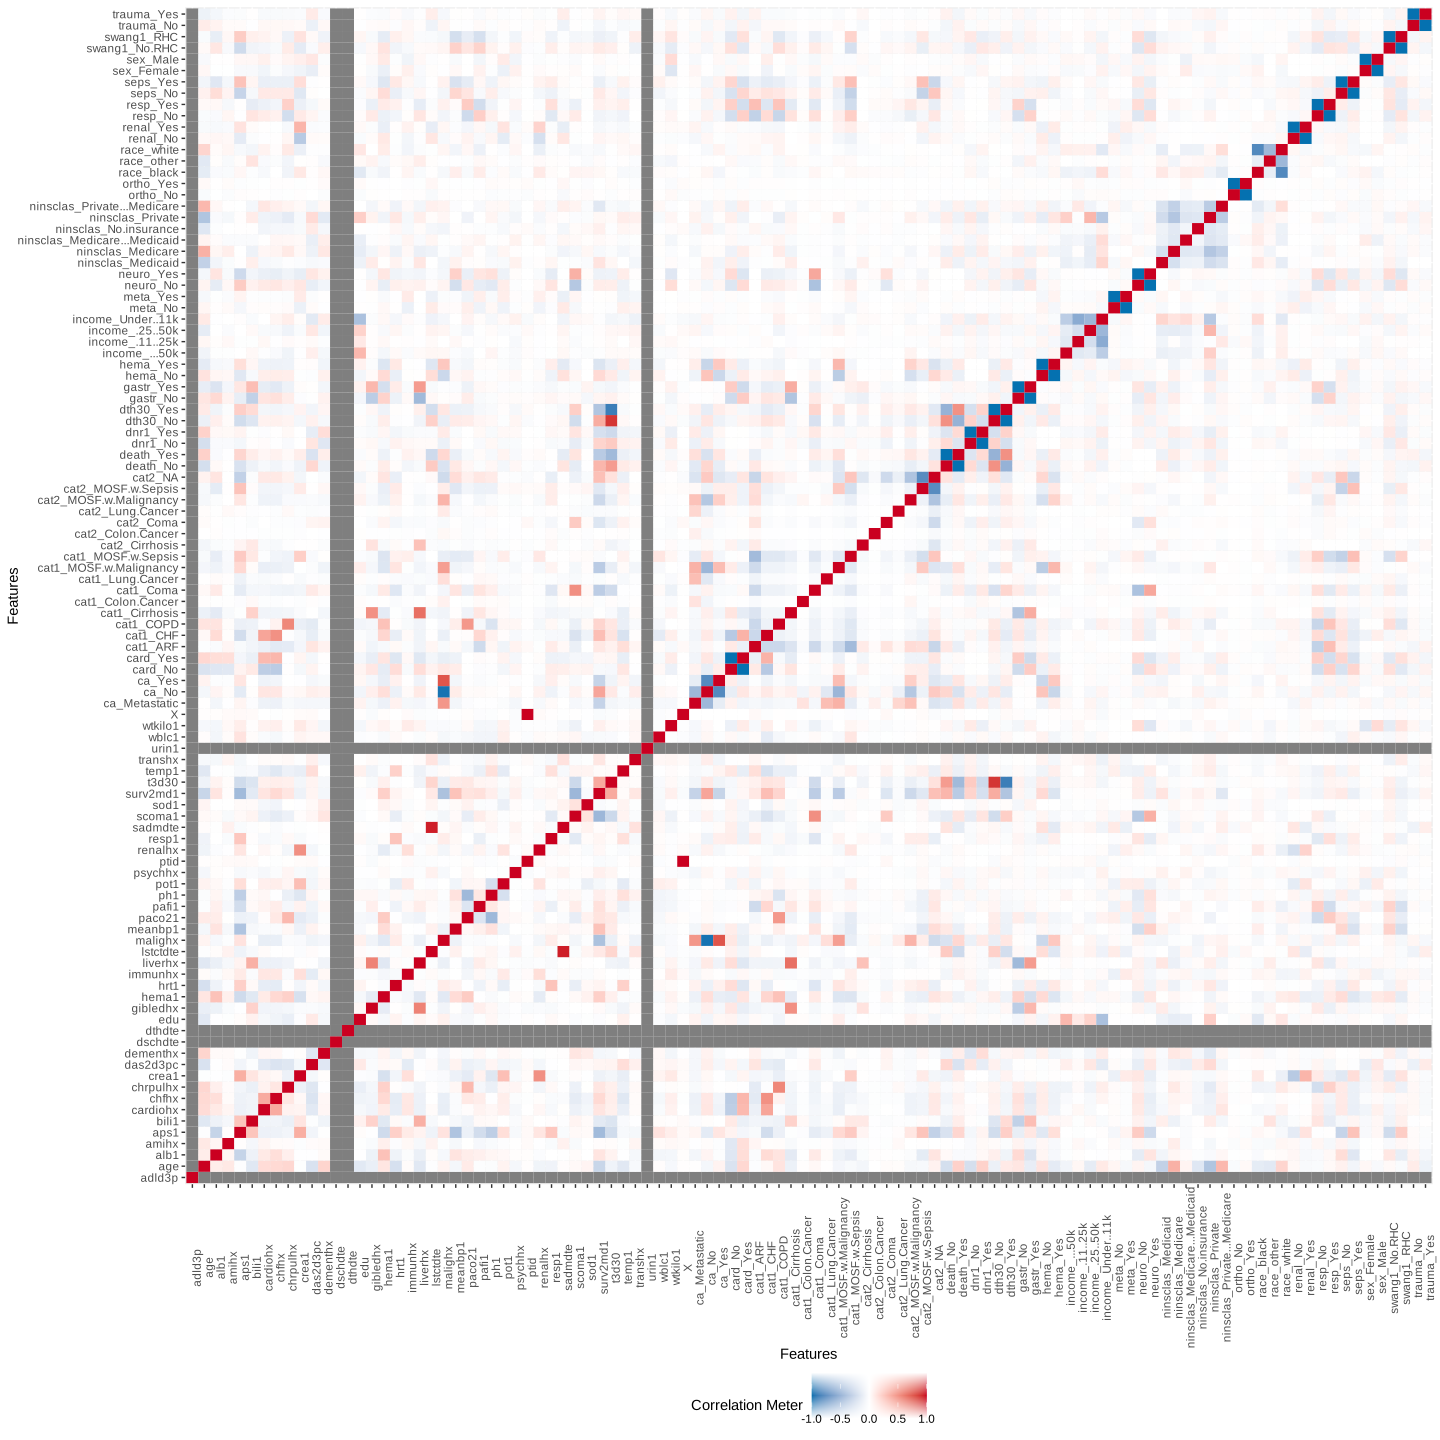
## Bivariat distribution stratifierat på en kolumn
plot_boxplot(rhc, by = "death")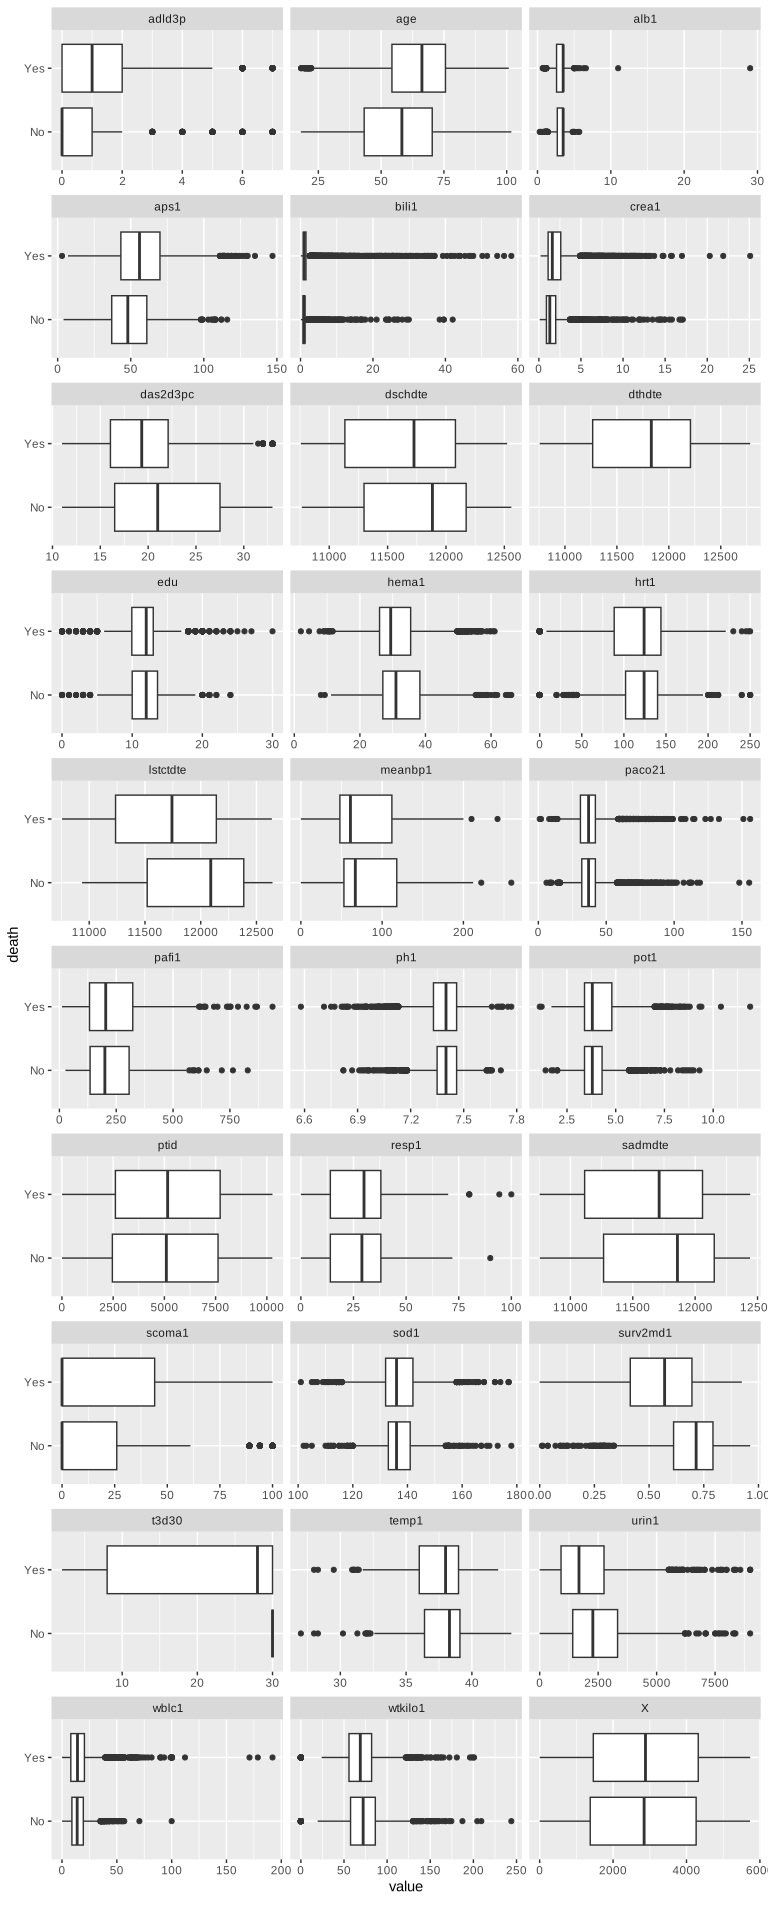
## Scatterplot `price` with all other continuous features
plot_scatterplot(split_columns(rhc)$continuous,
                 by = "age",
                 sampled_rows = 100L,
                 ncol=3, nrow=20)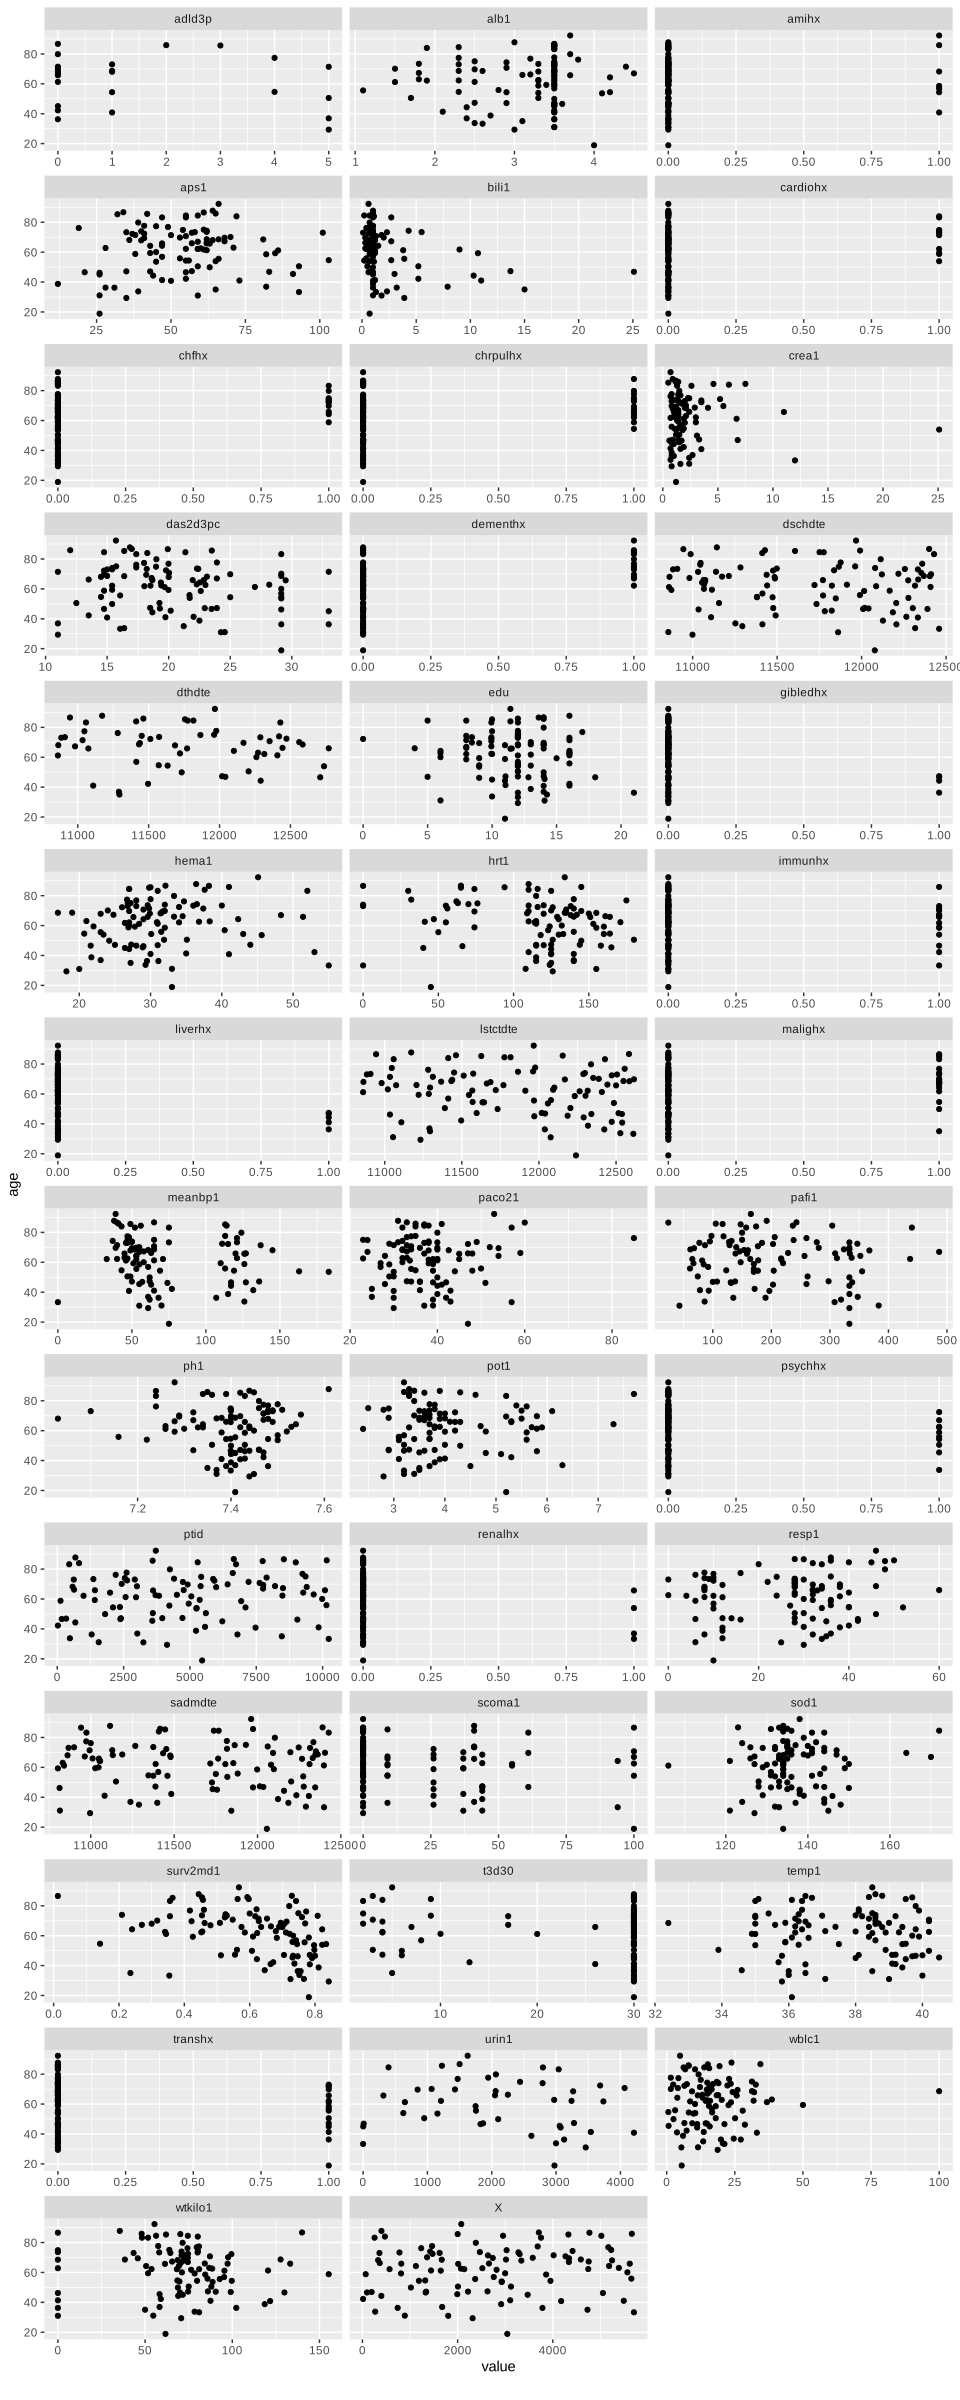
## Visualize principal component analysis
plot_prcomp(rhc, maxcat = 8L)