Det är viktigt att få en snabb sammanställning av kolumnerna i en data frame. Denna typ av analys används för att förvissa sig om att alla kolumner har förväntat innehåll. Såvida inte datainsamling skett mycket omsorgsfullt är det sannolikt att en eller flera variabler inte har förväntad formatering. Förekomst av ett enda icke-numeriskt tecken i en kolumn med datum eller numeriska värden räcker för att hela kolumnen ska tolkas som en textkolumn i R.
Det finns ett antal olika paket och funktioner för att generera sammanställningar av data frames. Nedan följer ett antal funktioner med små men viktiga nyanser.
Vi börjar med paketet mlr som innehåller funktionen summarizeColumns(). Paketet mlr måste vara installerat för att funktionen ska kunna användas. Installera och aktivera paketet enligt följande:
install.packages("mlr")
library(mlr)
mlr tenderar att använda scientific notation, vilket innebär att stora och små tal skrivs ut som exponenttal; exempelvis skrivs 100000000 ut som 1e+08. Du kan stänga av scientific notation med följande kommando:
## Stäng av scientific notation i R
options(scipen = 999)
Använd sedan funktionen summarizeColumns() för att granska innehållet i vår data frame (rhc):
summarizeColumns(rhc)| name (variabelnamn) | type (variabeltyp) | na (antal missing) | mean (medelvärde) | disp (SD för numeriska värden; kvalitativ variation för kategoriska) | median (medianvärde) | mad (median absolute deviation; NA för kategoriska kolumner) | min (minsta värde) | max (största värde) | nlevs (antal nivåer för kategoriska variabler; 0 för numeriska) |
|---|---|---|---|---|---|---|---|---|---|
| adld3p | integer | 4296 | 1.18207088 | 1.819057175 | 0.0000000 | 0.00000000 | 0.00000000 | 7.0000000 | 0 |
| age | numeric | 0 | 61.37588300 | 16.681929290 | 64.0470000 | 16.96239695 | 18.04199000 | 101.8479600 | 0 |
| alb1 | numeric | 0 | 3.09274278 | 0.783276789 | 3.5000000 | 0.29680955 | 0.29998780 | 29.0000000 | 0 |
| amihx | integer | 0 | 0.03487358 | 0.183475574 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| aps1 | integer | 0 | 54.66765475 | 19.956433845 | 54.0000000 | 19.27380000 | 3.00000000 | 147.0000000 | 0 |
| bili1 | numeric | 0 | 2.26706698 | 4.801537560 | 1.0097656 | 0.43001193 | 0.09999084 | 58.1953125 | 0 |
| ca | character | 0 | NA | 0.236442895 | NA | NA | 384.00000000 | 4379.0000000 | 3 |
| card | character | 0 | NA | 0.336704446 | NA | NA | 1931.00000000 | 3804.0000000 | 2 |
| cardiohx | integer | 0 | 0.17663470 | 0.381392509 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| cat1 | character | 0 | NA | 0.565823888 | NA | NA | 7.00000000 | 2490.0000000 | 9 |
| cat2 | character | 4535 | NA | NA | NA | NA | 2.00000000 | 826.0000000 | 6 |
| chfhx | integer | 0 | 0.17802964 | 0.382571052 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| chrpulhx | integer | 0 | 0.18988666 | 0.392245516 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| crea1 | numeric | 0 | 2.13301689 | 2.053079758 | 1.5000000 | 0.88970479 | 0.09999084 | 25.0976562 | 0 |
| das2d3pc | numeric | 0 | 20.49688754 | 5.317185677 | 19.7460900 | 5.46708750 | 11.00000000 | 33.0000000 | 0 |
| death | character | 0 | NA | 0.351002616 | NA | NA | 2013.00000000 | 3722.0000000 | 2 |
| dementhx | integer | 0 | 0.09834350 | 0.297804507 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| dnr1 | character | 0 | NA | 0.114036617 | NA | NA | 654.00000000 | 5081.0000000 | 2 |
| dschdte | integer | 1 | 11660.05040112 | 513.447322056 | 11777.0000000 | 658.27440000 | 10757.00000000 | 12560.0000000 | 0 |
| dth30 | character | 0 | NA | 0.334437663 | NA | NA | 1918.00000000 | 3817.0000000 | 2 |
| dthdte | integer | 2013 | 11753.86915637 | 538.812330065 | 11831.5000000 | 675.32430000 | 10757.00000000 | 12783.0000000 | 0 |
| edu | numeric | 0 | 11.67846146 | 3.145831004 | 12.0000000 | 2.96520000 | 0.00000000 | 30.0000000 | 0 |
| gastr | character | 0 | NA | 0.164254577 | NA | NA | 942.00000000 | 4793.0000000 | 2 |
| gibledhx | integer | 0 | 0.03225806 | 0.176700102 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| hema | character | 0 | NA | 0.061726242 | NA | NA | 354.00000000 | 5381.0000000 | 2 |
| hema1 | numeric | 0 | 31.86547859 | 8.363786134 | 30.0000000 | 6.82227582 | 2.00000000 | 66.1875000 | 0 |
| hrt1 | integer | 0 | 115.17890148 | 41.244941234 | 124.0000000 | 29.65200000 | 0.00000000 | 250.0000000 | 0 |
| immunhx | integer | 0 | 0.26904969 | 0.443504514 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| income | character | 0 | NA | 0.437489102 | NA | NA | 451.00000000 | 3226.0000000 | 4 |
| liverhx | integer | 0 | 0.06992153 | 0.255036968 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| lstctdte | integer | 0 | 11781.25789015 | 524.094168229 | 11868.0000000 | 673.10040000 | 10756.00000000 | 12644.0000000 | 0 |
| malighx | integer | 0 | 0.22946818 | 0.420527489 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| meanbp1 | numeric | 0 | 78.52005231 | 38.046582141 | 63.0000000 | 26.68680000 | 0.00000000 | 259.0000000 | 0 |
| meta | character | 0 | NA | 0.046207498 | NA | NA | 265.00000000 | 5470.0000000 | 2 |
| neuro | character | 0 | NA | 0.120836966 | NA | NA | 693.00000000 | 5042.0000000 | 2 |
| ninsclas | character | 0 | NA | 0.703923278 | NA | NA | 322.00000000 | 1698.0000000 | 6 |
| ortho | character | 0 | NA | 0.001220575 | NA | NA | 7.00000000 | 5728.0000000 | 2 |
| paco21 | numeric | 0 | 38.74897496 | 13.183444618 | 37.0000000 | 8.89560000 | 1.00000000 | 156.0000000 | 0 |
| pafi1 | numeric | 0 | 222.27370952 | 114.953087434 | 202.5000000 | 122.31450000 | 11.59961000 | 937.5000000 | 0 |
| ph1 | numeric | 0 | 7.38841349 | 0.109811941 | 7.3999980 | 0.08890114 | 6.57910200 | 7.7695310 | 0 |
| pot1 | numeric | 0 | 4.06669330 | 1.028353060 | 3.7998050 | 0.74130000 | 1.09985400 | 11.8984380 | 0 |
| psychhx | integer | 0 | 0.06730602 | 0.250573071 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
Du kan kombinera dplyr funktioner (t ex filter, select) med summarizeColumns() för att granska kolumnernas karaktäristika i en subgrupp i datamängden. Här nedan gör vi om tabellen ånyo men inkluderar endast patienter som inte hade cancer (ca="No"):
rhc |>
  filter(ca=="No") |>
  summarizeColumns()
Endast de första 4 variablerna visas nedan.
| name | type | na | mean | disp | median | mad | min | max | nlevs |
|---|---|---|---|---|---|---|---|---|---|
| adld3p | integer | 3258 | 1.16859946 | 1.810469232 | 0.0000000 | 0.00000000 | 0.00000000 | 7.0000000 | 0 |
| age | numeric | 0 | 60.88398987 | 16.971172590 | 63.4929800 | 17.66669125 | 18.14600000 | 101.8479600 | 0 |
| alb1 | numeric | 0 | 3.11450956 | 0.703468345 | 3.5000000 | 0.29680955 | 0.29998780 | 11.0000000 | 0 |
| amihx | integer | 0 | 0.03653802 | 0.187646040 | 0.0000000 | 0.00000000 | 0.00000000 | 1.0000000 | 0 |
| ... | ... | ... | ... | ... | ... | ... | ... | ... | ... |
Med summarizeColumns() genereras ingen information om kategoriska variablers (factors) nivåer. För att erhålla detta används följande kommando:
summarizeLevels(rhc)$ca
Metastatic No Yes
384 4379 972
$card
No Yes
3804 1931
$cat1
ARF CHF Cirrhosis Colon Cancer Coma COPD
2490 456 224 7 436 457
Lung Cancer MOSF w/Malignancy MOSF w/Sepsis
39 399 1227
$cat2
Cirrhosis Colon Cancer Coma Lung Cancer MOSF w/Malignancy MOSF w/Sepsis
38 2 90 15 229 826
$death
No Yes
2013 3722
$dnr1
No Yes
5081 654
$dth30
No Yes
3817 1918
$gastr
No Yes
4793 942
$hema
No Yes
5381 354
$income
> $50k $11-$25k $25-$50k Under $11k
451 1165 893 3226Screening med Hmisc
I paketet Hmisc finns en rad användbara funktioner för exploration och analys. Funktionen describe() används för att beskriva alla kolumner i en data frame. Börja med att installera Hmisc och aktivera paketet:
install.packages("Hmisc")
library(Hmisc)
Nu skapar vi objektet rhc_described genom att tillämpa funktionen describe() på vår data frame. Därefter skriver vi ut resultatet med funktionen html().
rhc_described <- describe(rhc)
html(rhc_described, size = 80)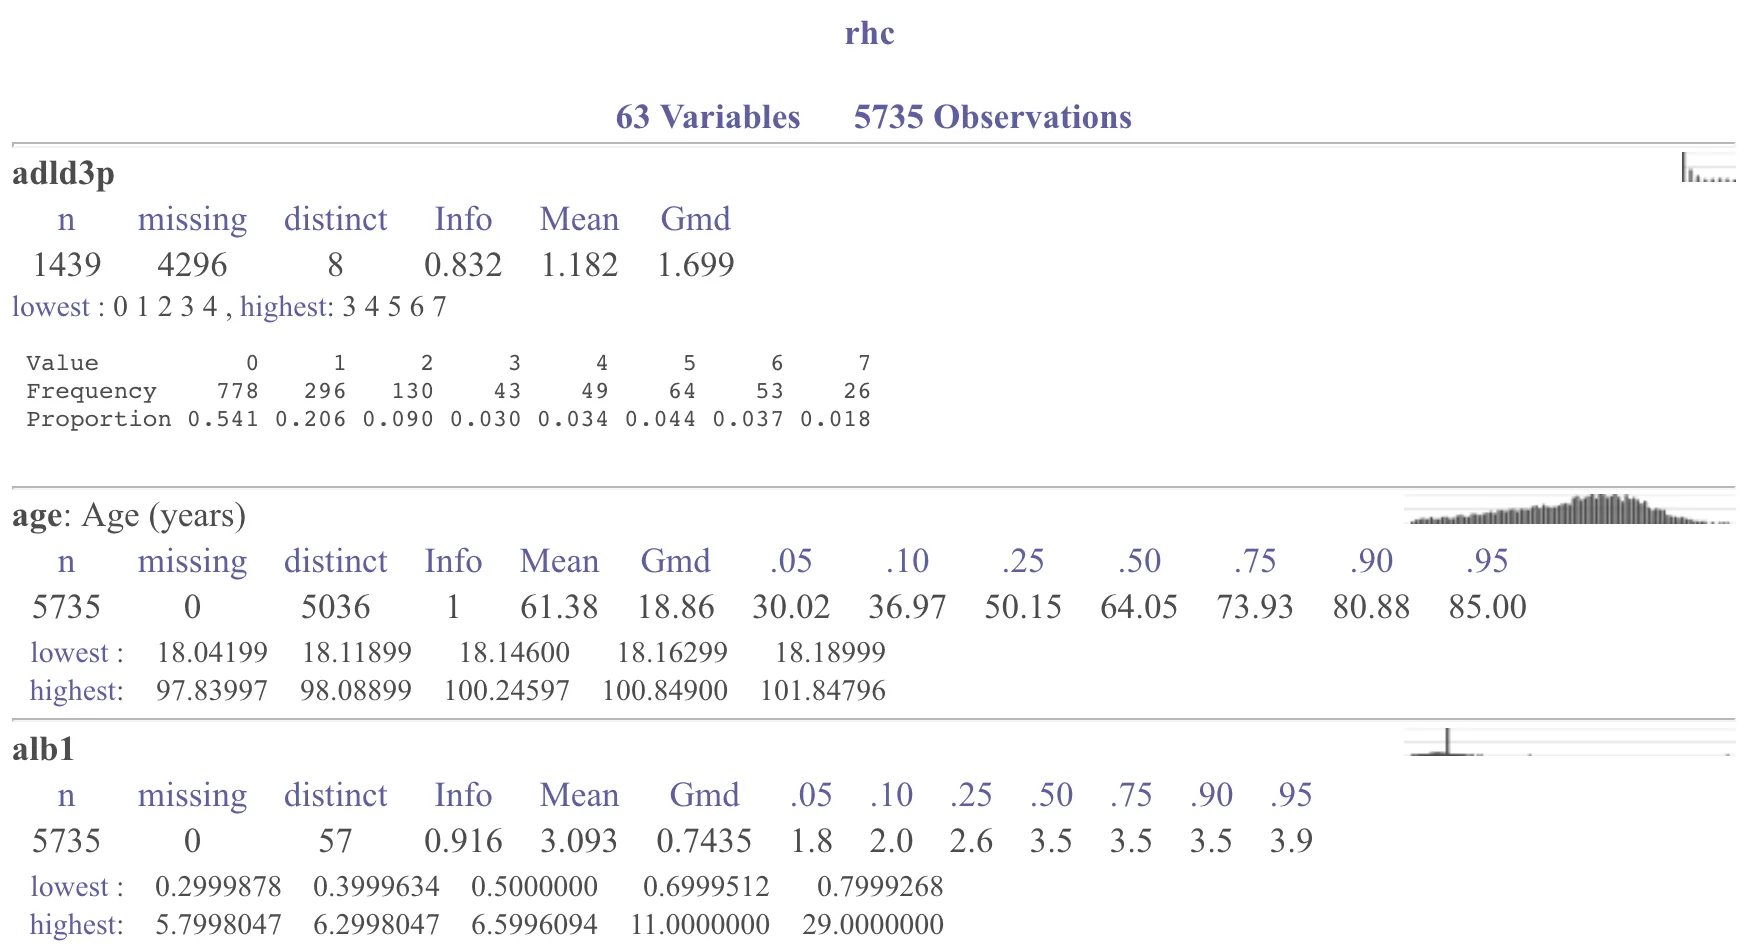
I nästa steg använder vi fler funktioner i Hmisc för att generera frekvensdiagram och histogram. Se kommentarer i koden för detaljer:
## Tillämpar funktionen plot() på vårt objekt rhc_described
rhc_described_plots <- plot(rhc_described)

## Inspekterar fördelningar i kategoriska data
rhc_described_plots$Categorical

## Inspekterar histogram för kontinuerliga data
rhc_described_plots$Categorical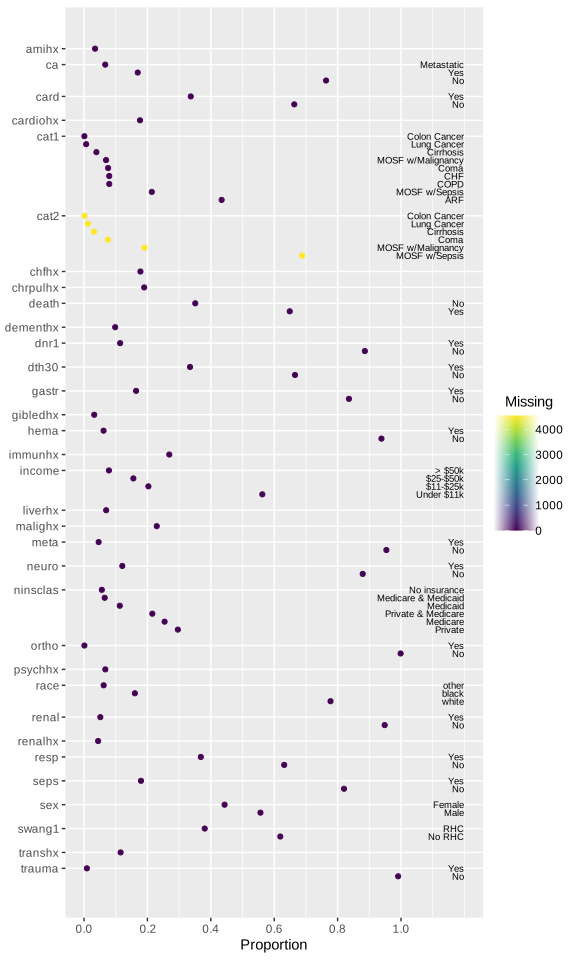
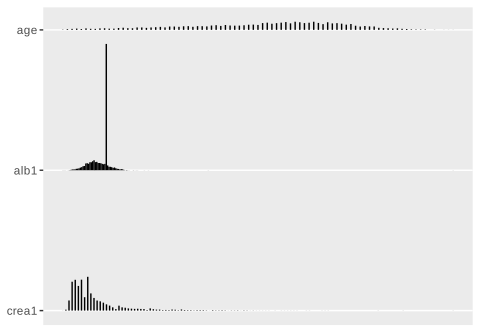
Generera kolumndata stratifierat på en kategorisk variabel
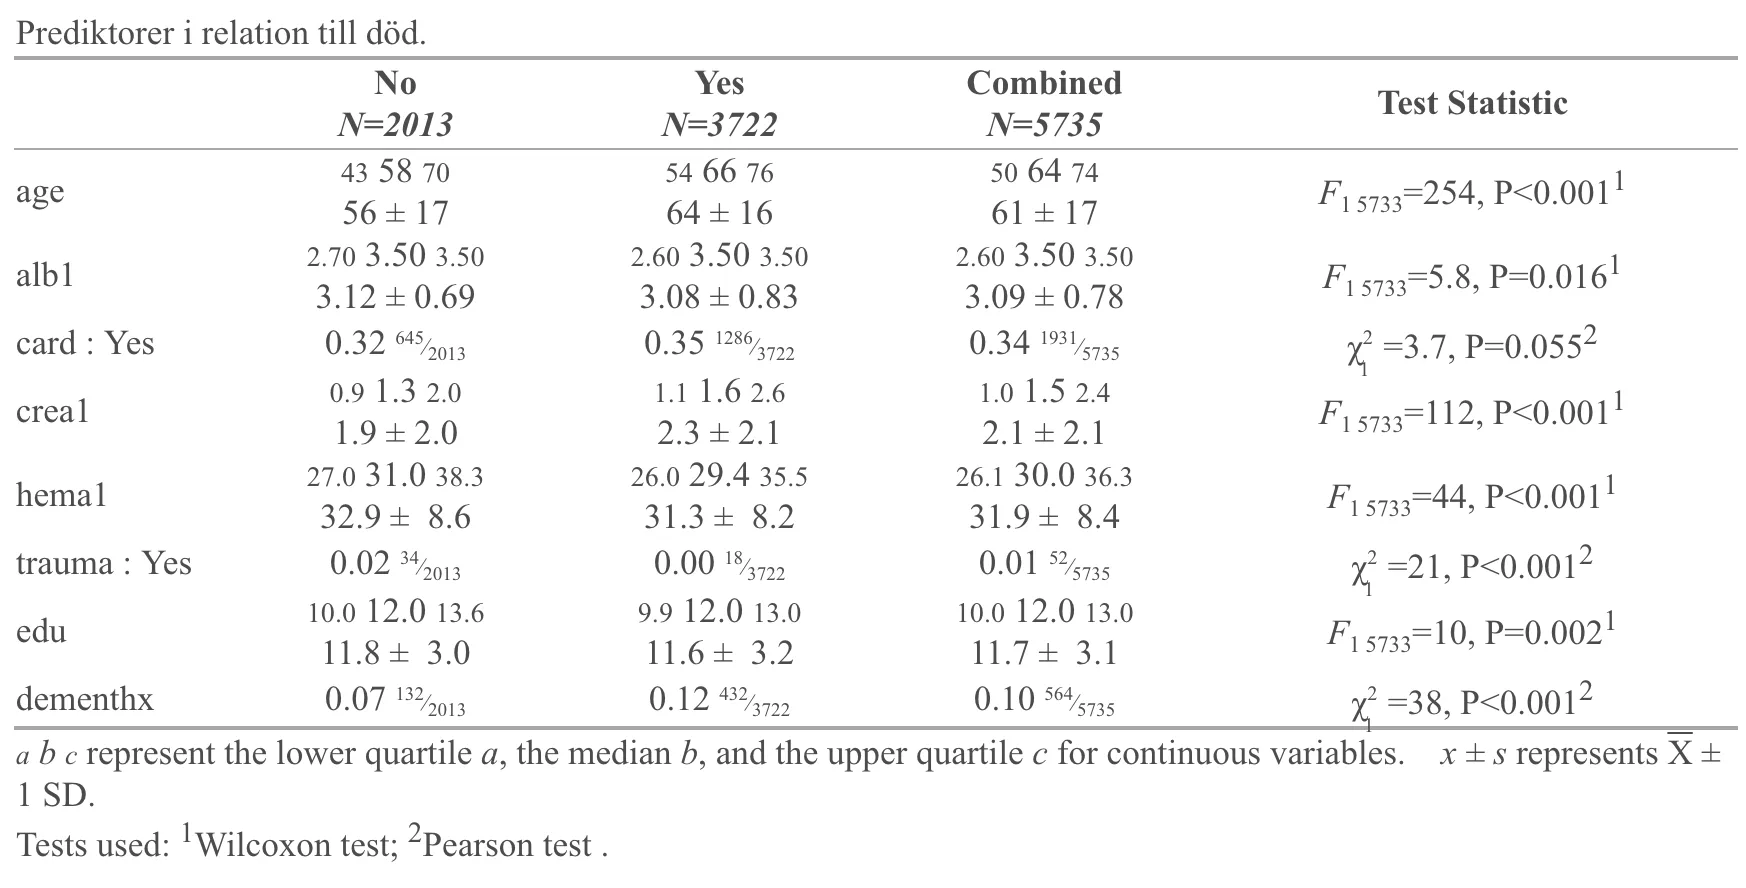
I Hmisc finns funktionen summaryM() som redovisar variablers karaktäristika stratifierat på en kategorisk variabel. Den kategoriska variabeln brukar vara ett utfallsmått (event, outcome) i studien. Funktionen summaryM() är speciell då den använder en formel för att specificera variabler som skall redovisas. Funktionen beräknar även olika typer av hypotestester för gruppskillnader. Huruvida sådana hypotestester (P värden) är användbara eller inte beror på kontexten. Det är oftast olämpligt att göra hypotestester slentrianmässigt i jakten på gruppskillnader eller för att identifiera vilka variabler som skall inkluderas i en statistisk modell.
Här nedan demonstreras funktionen. Observera att variabler vi vill granska placeras till vänster om tilde (~), separerade med +, och outcome placeras till höger om ~. Vi tillämpar funktionen html() på resultatet för att få estetiskt tilltalande resultat.
rhc_summary <- summaryM(age + alb1 + card + crea1 + hema1 + trauma + edu + dementhx ~ death,
              data = rhc,
              overall = TRUE,
              test = TRUE)

html(rhc_summary,
     caption='Prediktorer i relation till död',
     exclude1 = TRUE,
     npct = 'both',
     digits = 2,
     prmsd = TRUE,
     brmsd = TRUE)