Flera geometriska objekt (eng. geoms) har inbyggda funktioner för statistiska transformationer och beräkningar. I flera tidigare kapitel har vi demonstrerat geom_smooth(), som beräknar och visualiserar sambandet mellan x och y. Funktionen geom_smooth() har argumentet method som kan sättas till "loess" för att generera en flexibel regressionslinje eller "lm" som genererar en linjär regressionslinje. Samma princip gäller för flera andra geom, vilket innebär att de genomför beräkningar för att visualisera data.
I detta kapitel kommer vi använda data från gapminder för att demonstrera hur transformationer fungerar. Vi börjar med att aktivera paketet gapminder och inspektera de första 10 raderna. Inspektion av data kan göras bland annat med funktionen head().
library(gapminder)
head(gapminder, 10)| country <fctr> | continent <fctr> | year <int> | lifeExp <dbl> | pop <int> | gdpPercap <dbl> |
|---|---|---|---|---|---|
| Afghanistan | Asia | 1952 | 28.801 | 8425333 | 779.4453 |
| Afghanistan | Asia | 1957 | 30.332 | 9240934 | 820.8530 |
| Afghanistan | Asia | 1962 | 31.997 | 10267083 | 853.1007 |
| Afghanistan | Asia | 1967 | 34.020 | 11537966 | 836.1971 |
| Afghanistan | Asia | 1972 | 36.088 | 13079460 | 739.9811 |
| Afghanistan | Asia | 1977 | 38.438 | 14880372 | 786.1134 |
| Afghanistan | Asia | 1982 | 39.854 | 12881816 | 978.0114 |
| Afghanistan | Asia | 1987 | 40.822 | 13867957 | 852.3959 |
| Afghanistan | Asia | 1992 | 41.674 | 16317921 | 649.3414 |
| Afghanistan | Asia | 1997 | 41.763 | 22227415 | 635.3414 |
Därefter gör vi ett stapeldiagram som visar hur många observationer (rader) som finns för varje kontinent. Detta görs med geom_bar() som skapar ett stapeldiagram. Den enda estetiska mappningen vi deklarerar är x=continent. Funktionen kommer automatiskt beräkna y-axeln (antal rader för varje kontinent).
ggplot(data=gapminder) +
  geom_bar(aes(x=continent))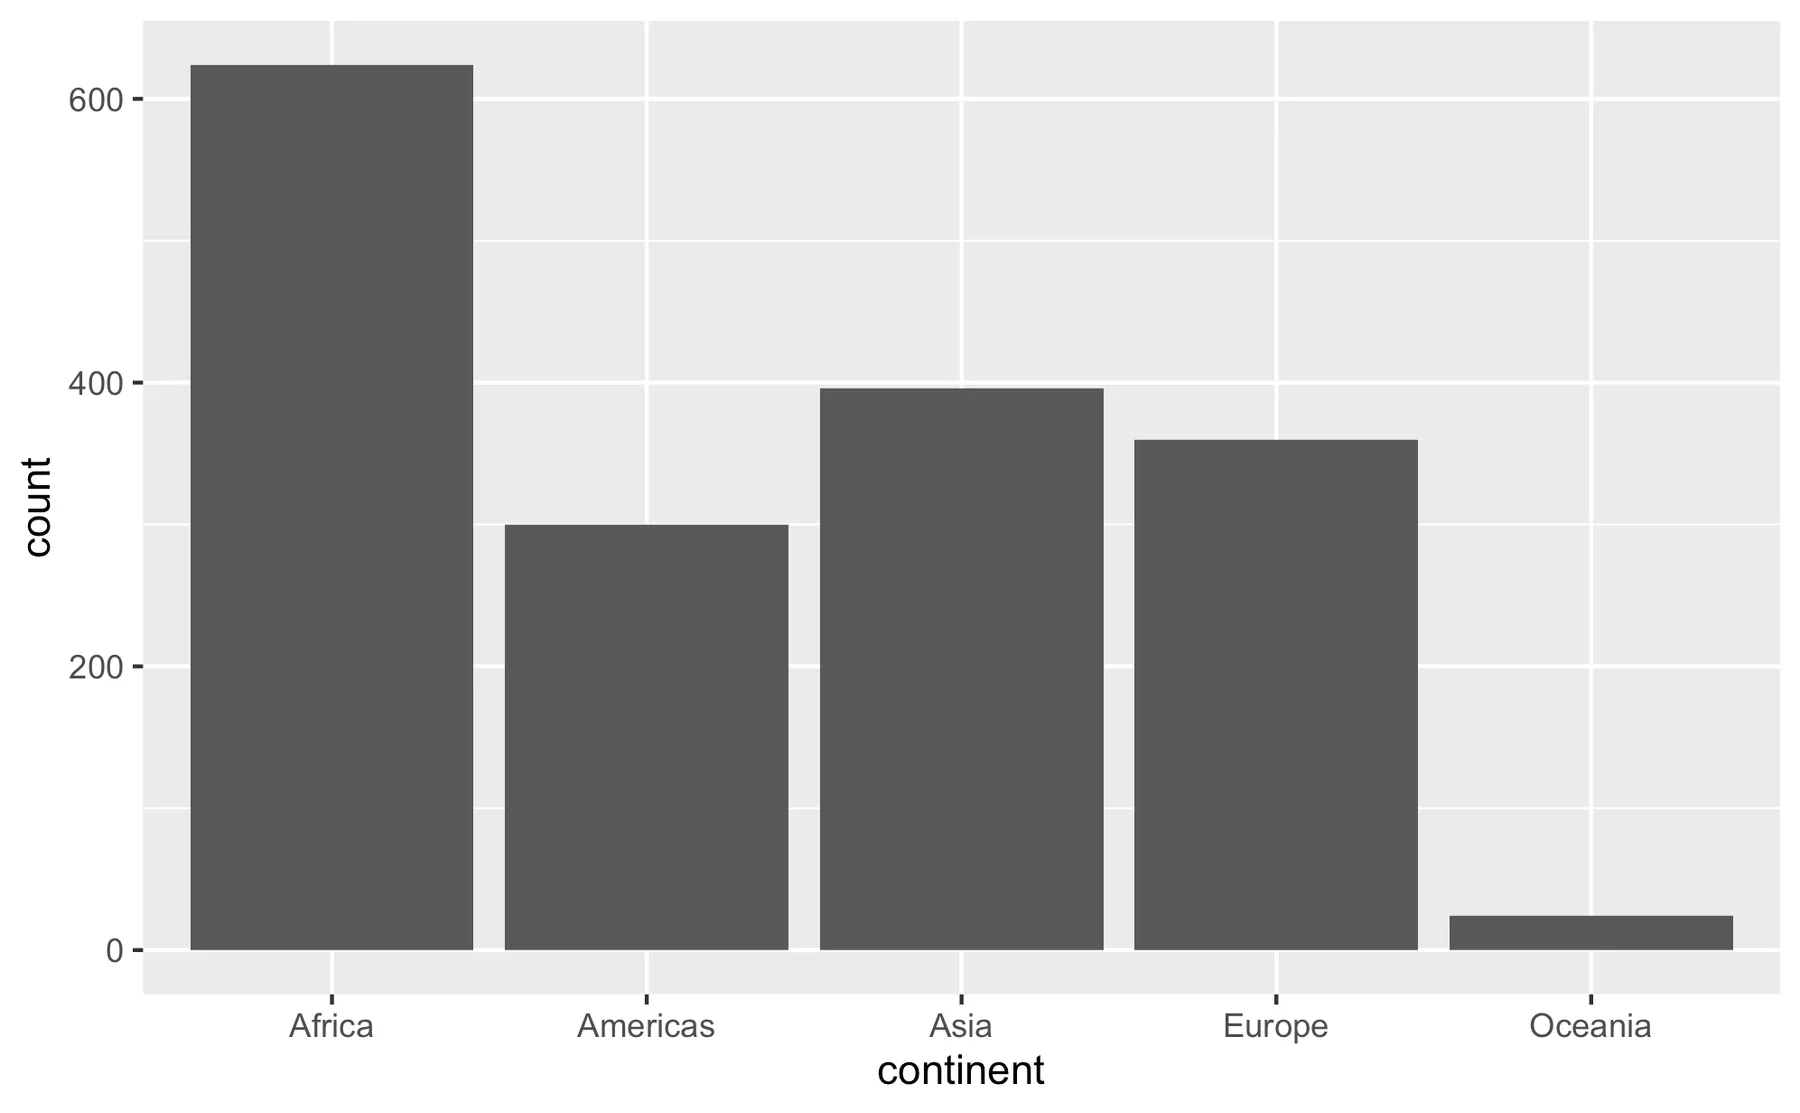
Ett alternativ till ovanstående är att själv beräkna antal observationer på varje kontinent. Det kan enkelt göras med funktionen count() i paketet dplyr. Du har förmodligen redan laddat dplyr eftersom det ingår i paketet tidyverse. Annars laddar vi det nu:
library(tidyverse)Funktionen count() räknar antal rader för en eller flera kategoriska variabler, enligt följande:
gapminder |>
count(continent)| continent <fctr> | n <int> |
|---|---|
| Africa | 624 |
| Americas | 300 |
| Asia | 396 |
| Europe | 360 |
| Oceania | 24 |
Som framgår ovan beräknas antal rader (n) för varje kontinent (continent).
Som framgår ovan beräknas antal rader (n) för varje kontinent (continent). Vi tar nu dessa data och skapar ett stapeldiagram som är identiskt med föregående. Eftersom geom_bar() inte längre skall beräkna y-axeln själv så berättar vi att y=n och vi använder argumentet stat="identity" för att berätta att värdena redan är beräknade. Notera också att vi kopplar ihop count() med ggplot() och därmed använder resultatet av count() direkt i ggplot(). Detta är möjligt eftersom pipe (|>) skickar vidare resultatet av en operation till nästa funktion där resultatet används som första argumentet (första argumentet i funktionen ggplot() är data).
gapminder |>
  count(continent) |>
  ggplot(aes(x=continent, y=n)) +
  geom_bar(stat="identity")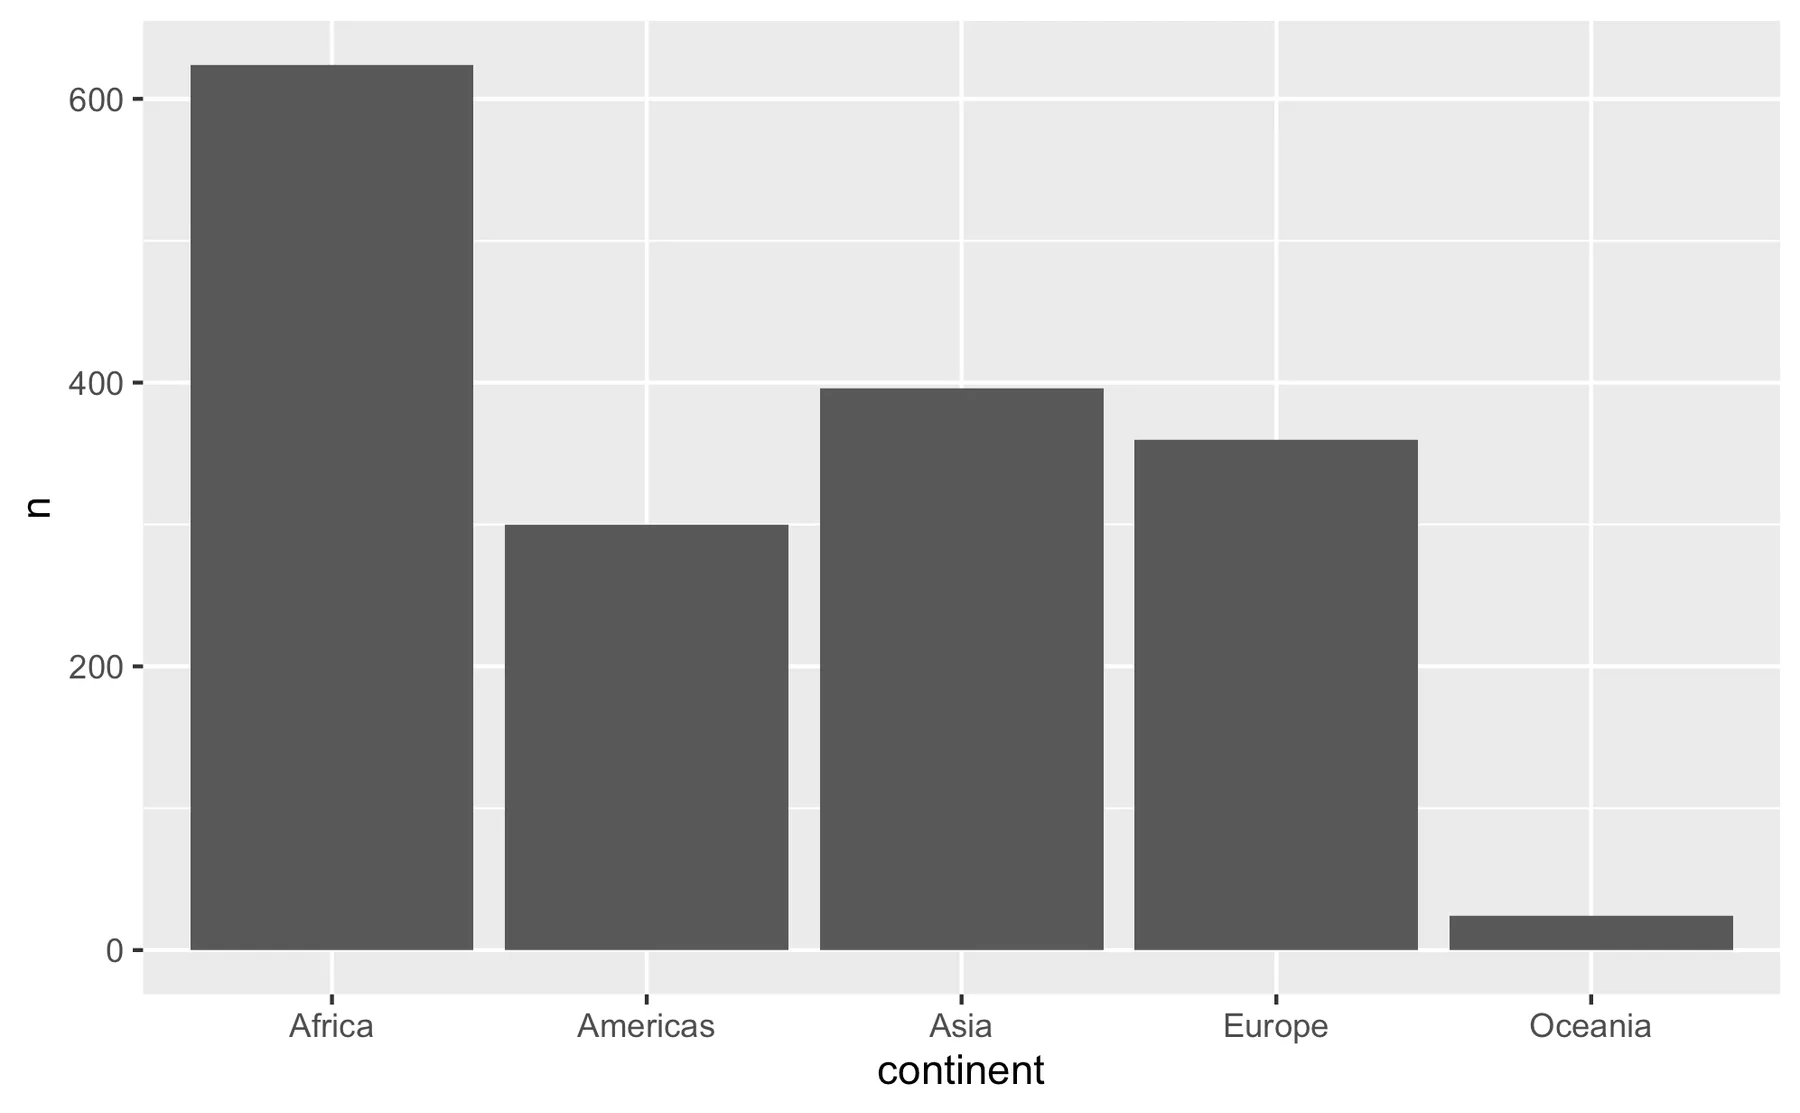
Det finns andra transformationer (beräkningar) inbyggda i geometriska objekt. Du har redan stött på geom_smooth() i föregående kapitel. Här följer andra exempel på geoms som gör beräkningar i samband med att de används:
geom_bar(),geom_histogram(),geom_freqpoly()beräknar summor och proportioner.geom_boxplot(),geom_violin()beräknar distributioner.geom_smooth()skapar en regressionsmodell som visualiseras.
I nästa exempel använder vi gapminder för att göra följande:
- Rad 2: Vi behåller endast länder i Afrika genom att filtrera med argumentet
continent=="Africa". - Rad 2: Vi behåller endast data från år 1997 genom att filtrera med argumentet
year==1997. - Rad 2: Vi kopplar ihop
ggplot()direkt med föregående operationer med|> - Rad 4: Vi skapar ett stapeldiagram där land är y-axeln och förväntad livslängd är x-axeln. Eftersom dessa värden redan är beräknade så används argumentet
stat="identity":
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=country,
               x=pop),
           stat="identity")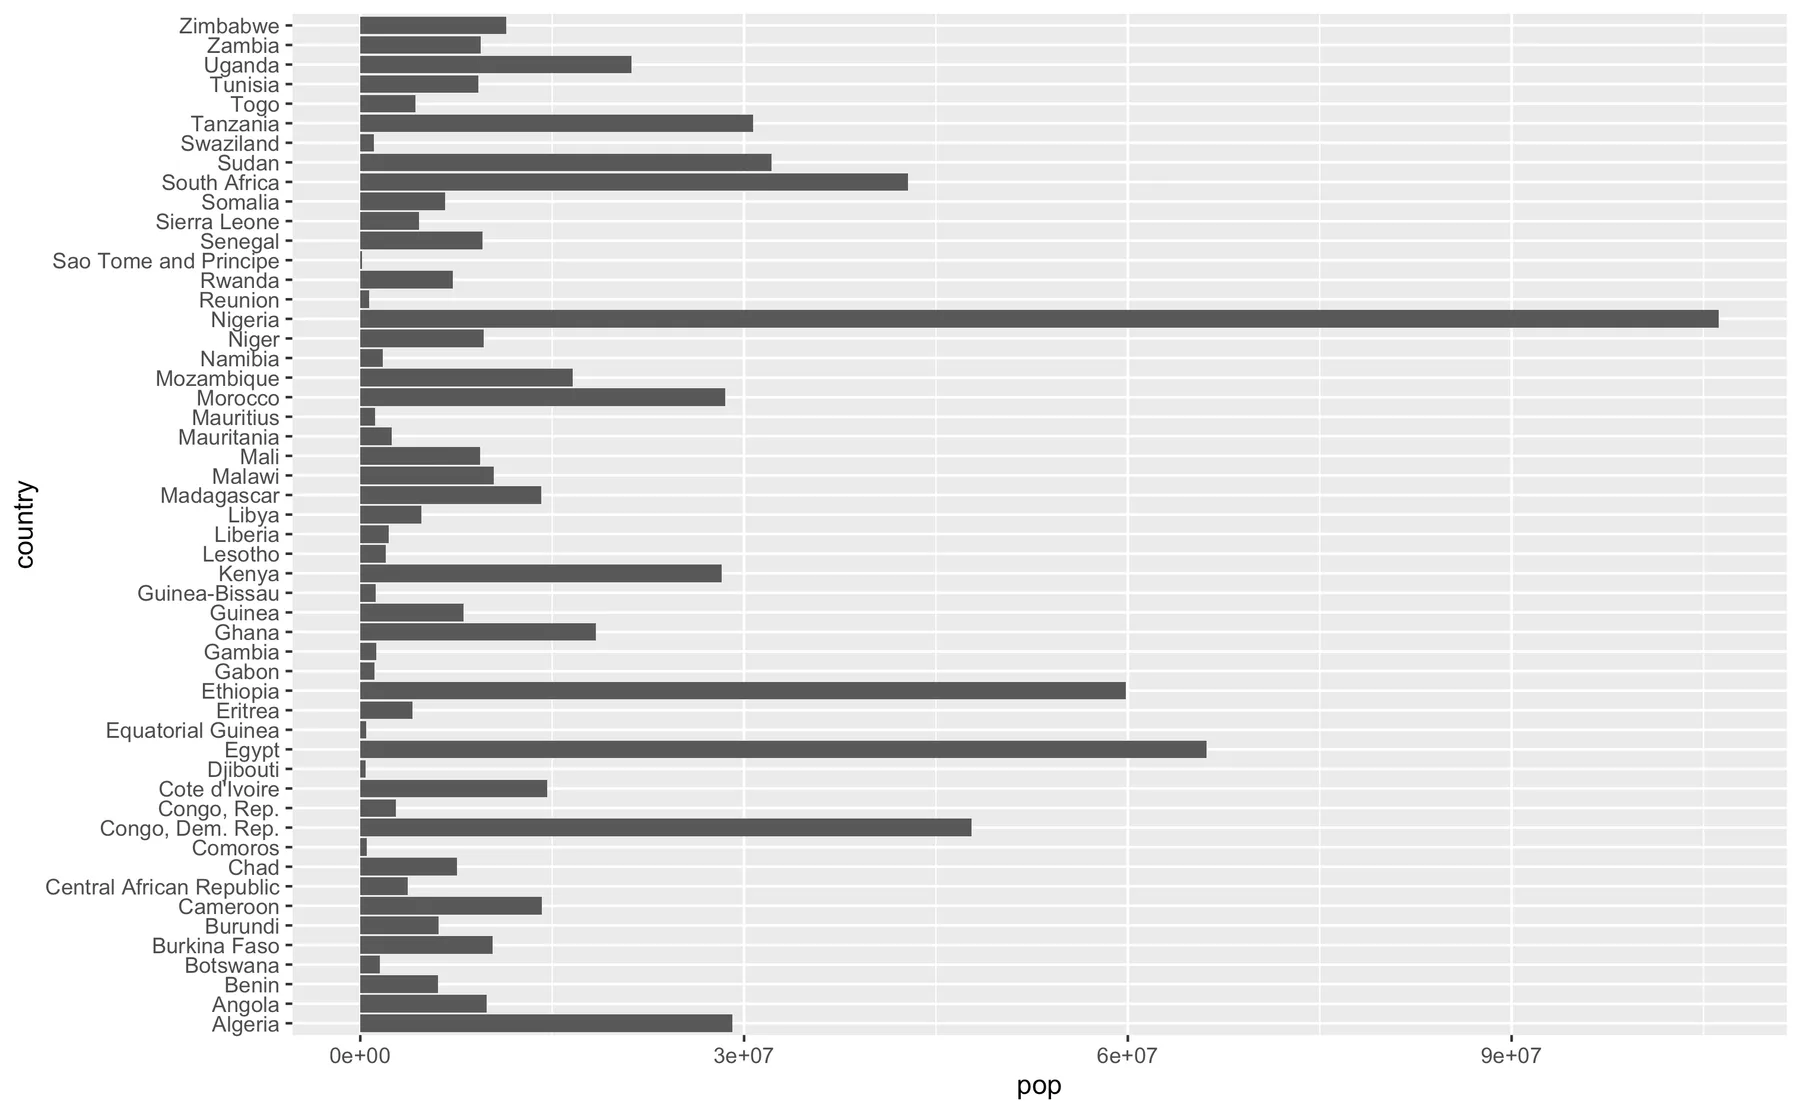
Vi fortsätter genom att sortera y-axeln på förväntad livslängd (lifeExp). Detta kan göras direkt i aes() med funktionen reorder(). I reorder specificeras vad som skall sorteras (country) och kolumnen den skall sorteras på (pop, som är befolkningsmängd). Se rad 4 nedan.
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=reorder(country, pop),
               x=pop),
           stat="identity")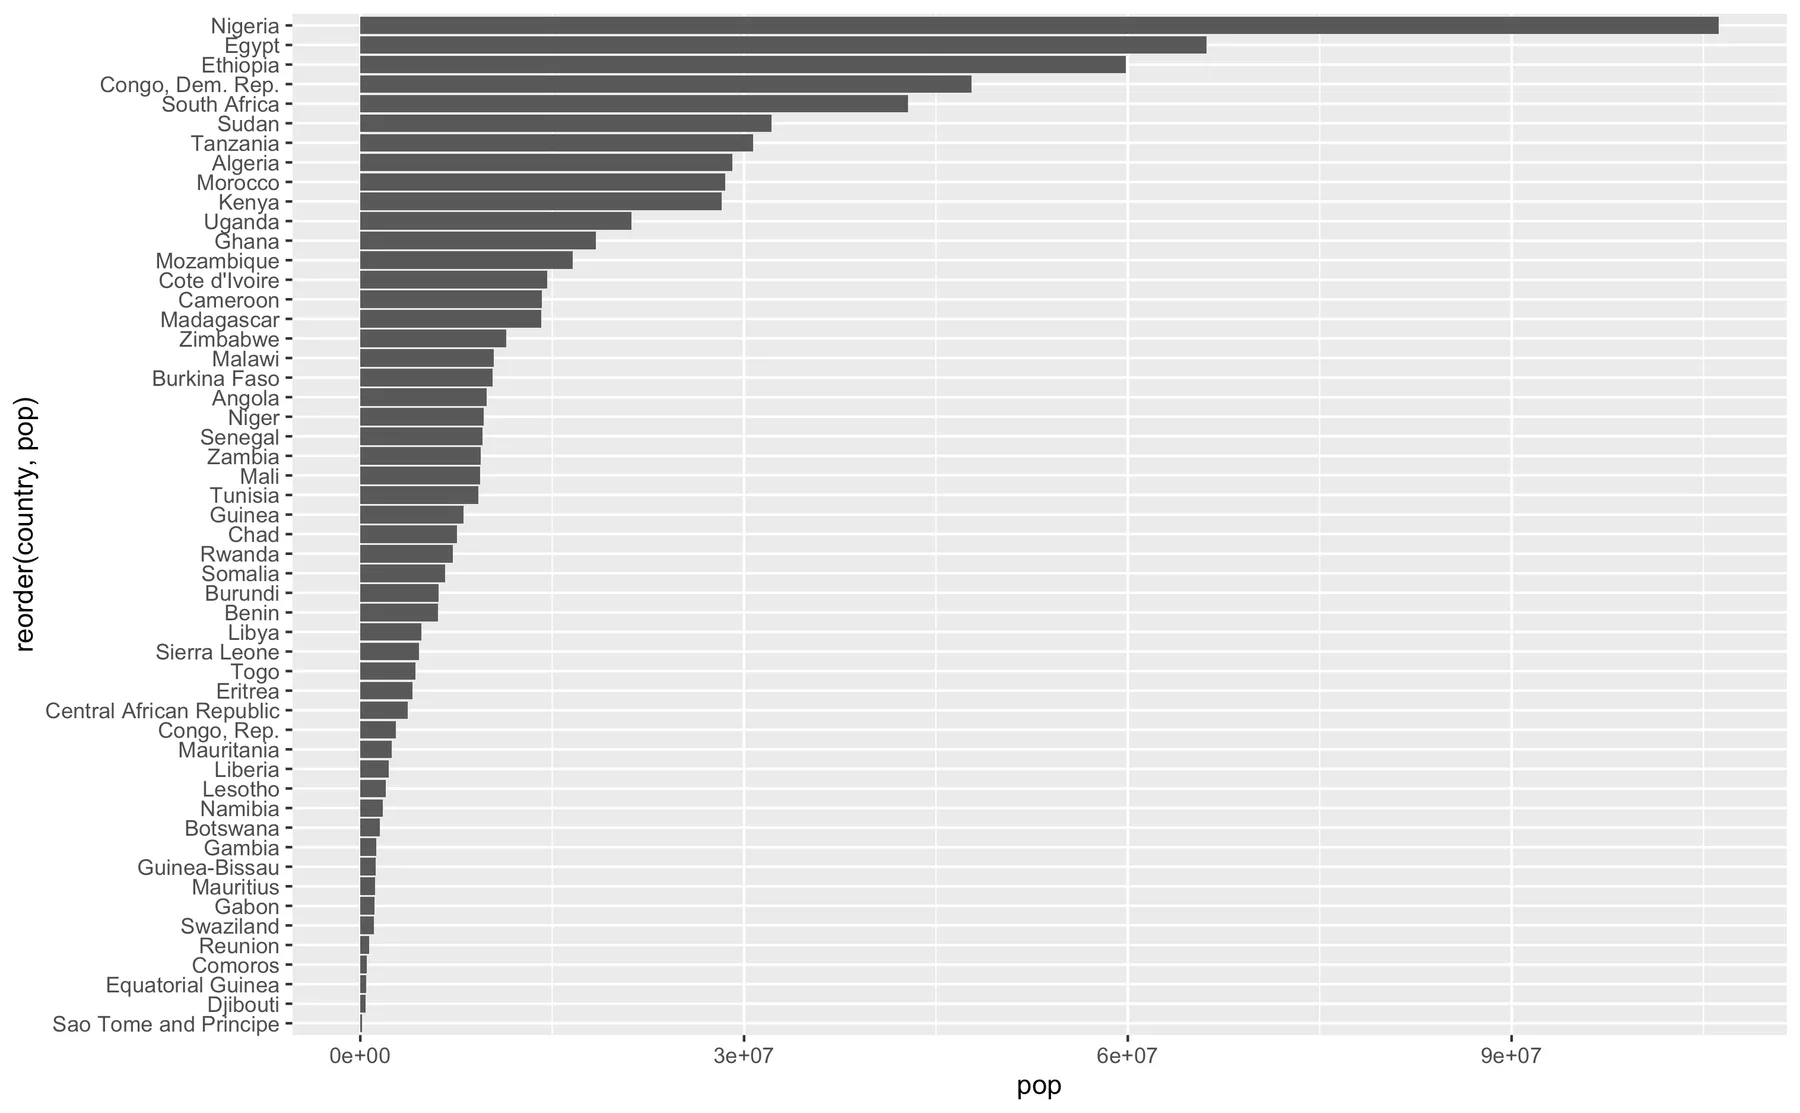
Ett minustecken (-) innan pop i reorder() resulterar i omvänd sortering, som följer (se rad 4):
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=reorder(country, -pop),
               x=pop),
           stat="identity")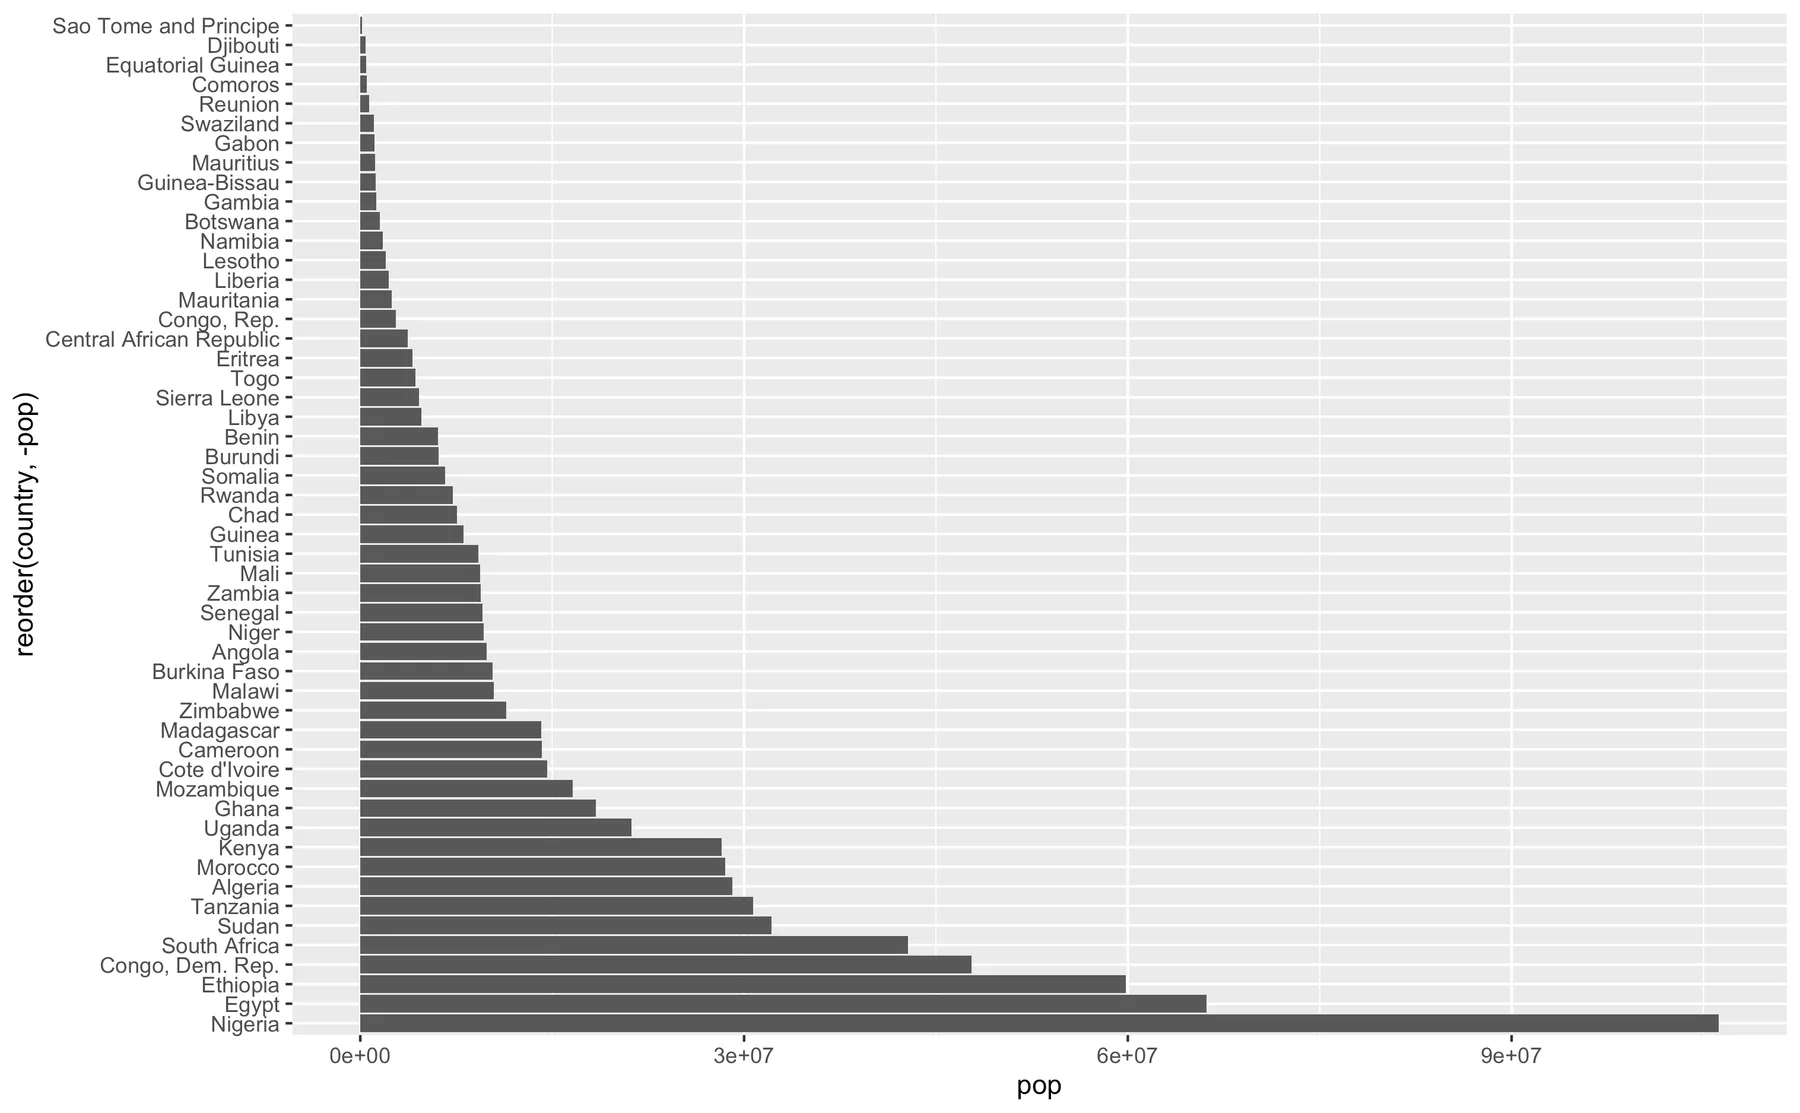
Vi behöver också visualisera den förväntade livslängden (lifeExp) för varje land och kan göra det genom argumentet fill(), enligt följande (rad 6):
gapminder |>
  filter(continent=="Africa", year==1997) |>
  ggplot()+
  geom_bar(aes(y=reorder(country, pop),
               x=pop,
               fill=lifeExp),
           stat="identity")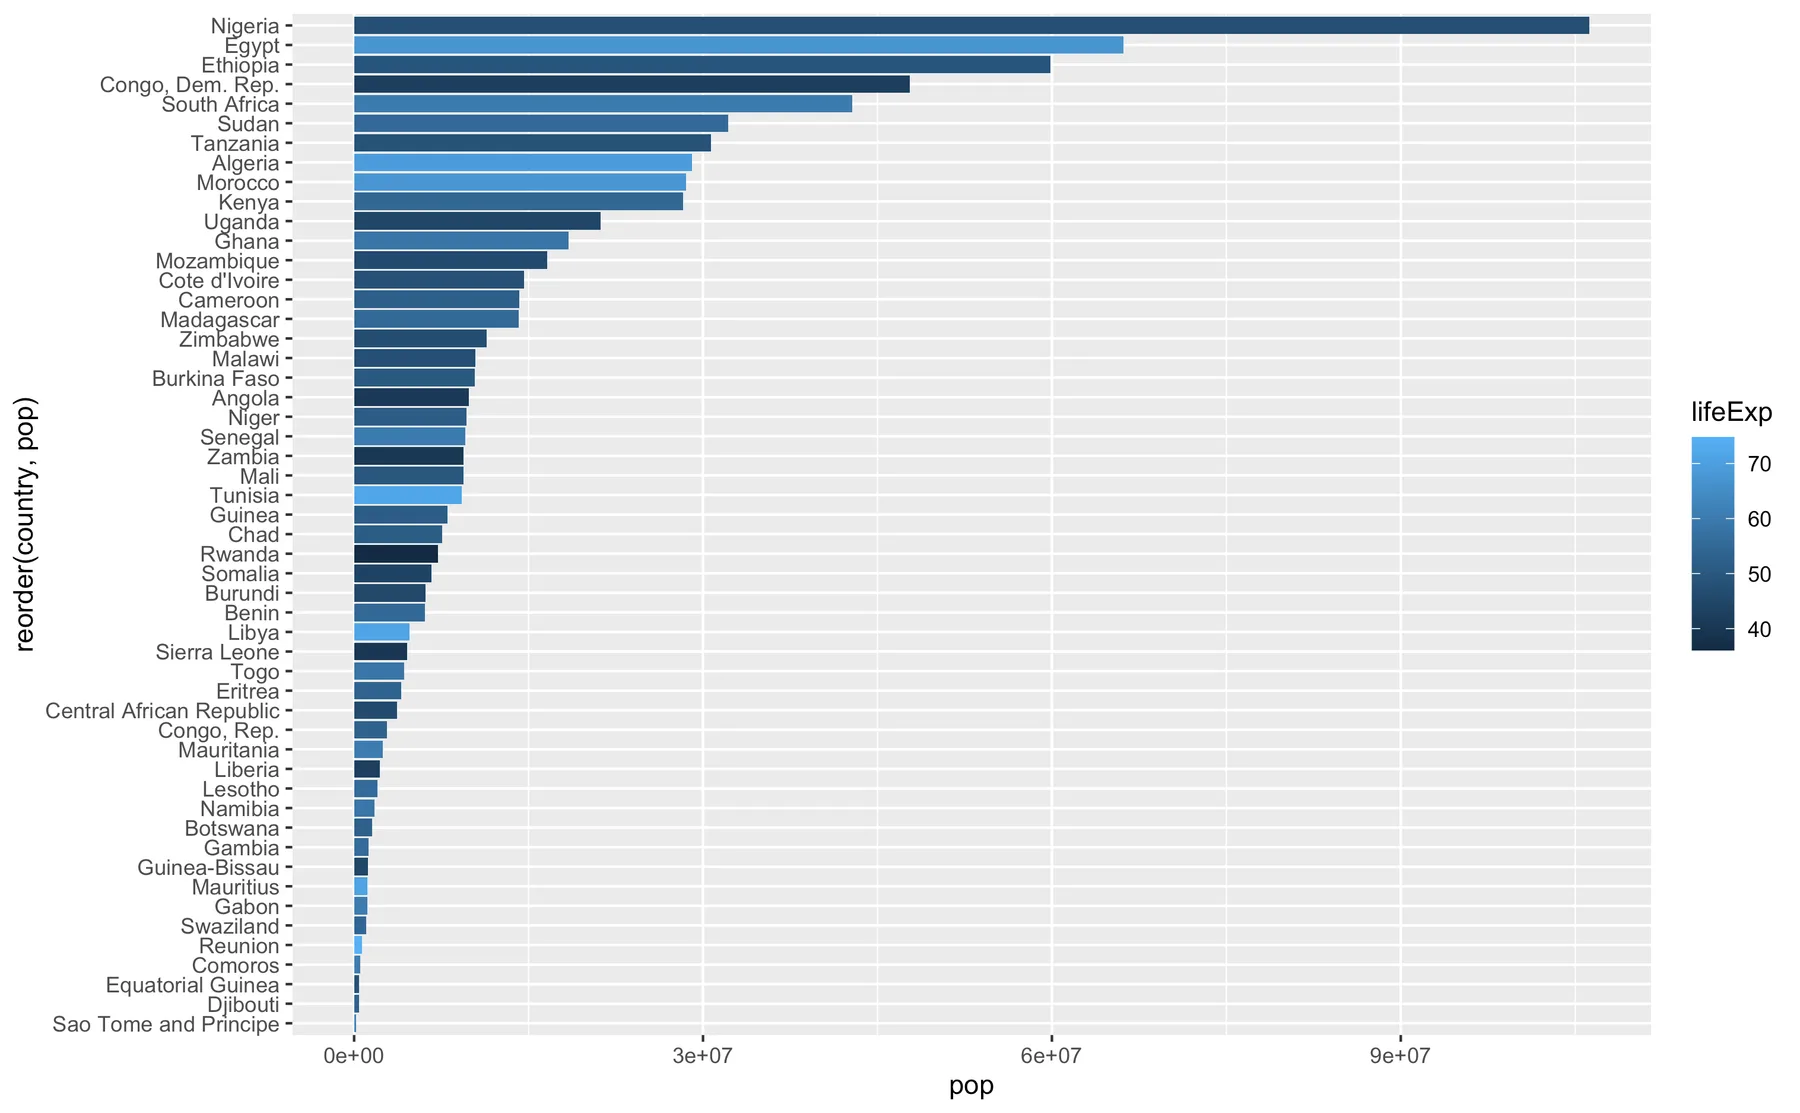
Proportioner
Med geom_bar() kan proportioner (prop) beräknas istället för antal (count). Detta görs genom en "efterberäkning" (after_stat) på y och genom att specificera group=1, vilket innebär att den totala andelen i alla kontinenter skall vara 1:
ggplot(data = gapminder) +
  geom_bar(mapping = aes(x = continent,
                         y = after_stat(prop),
                         group = 1))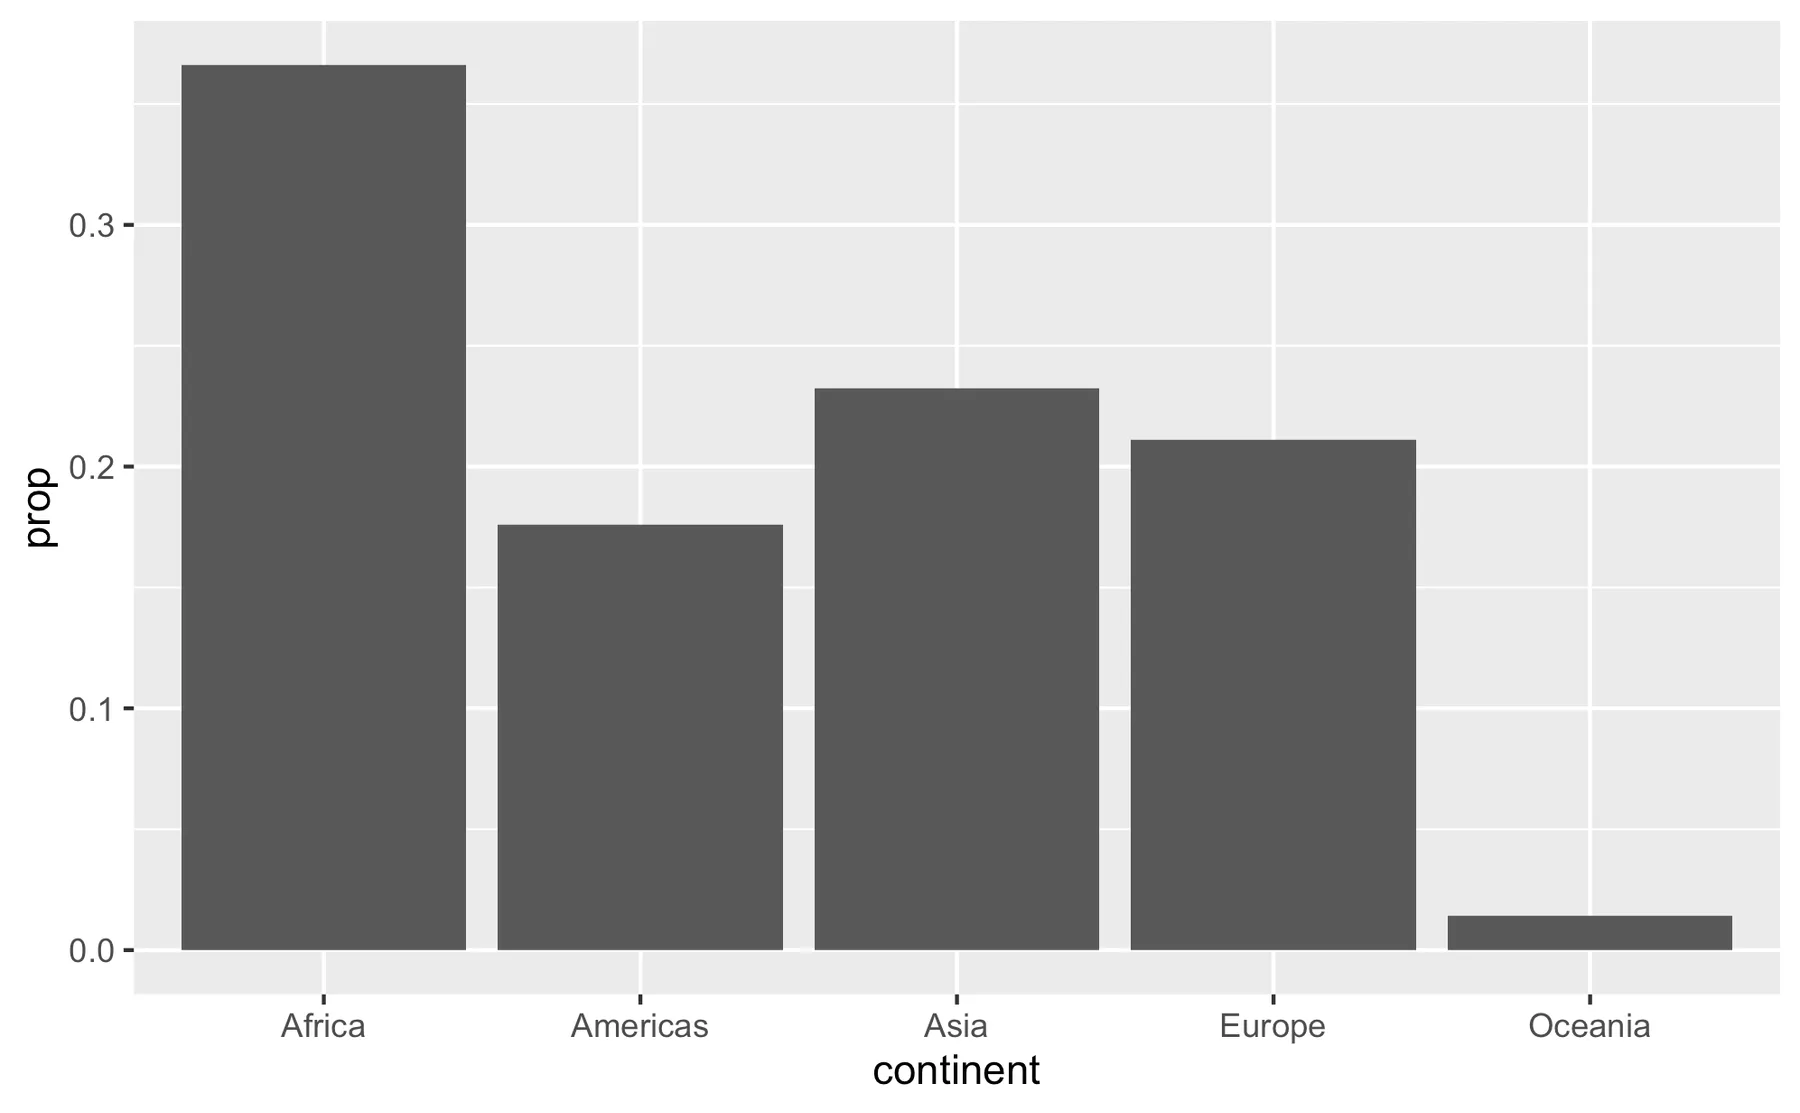
Stat summary: stat_summary()
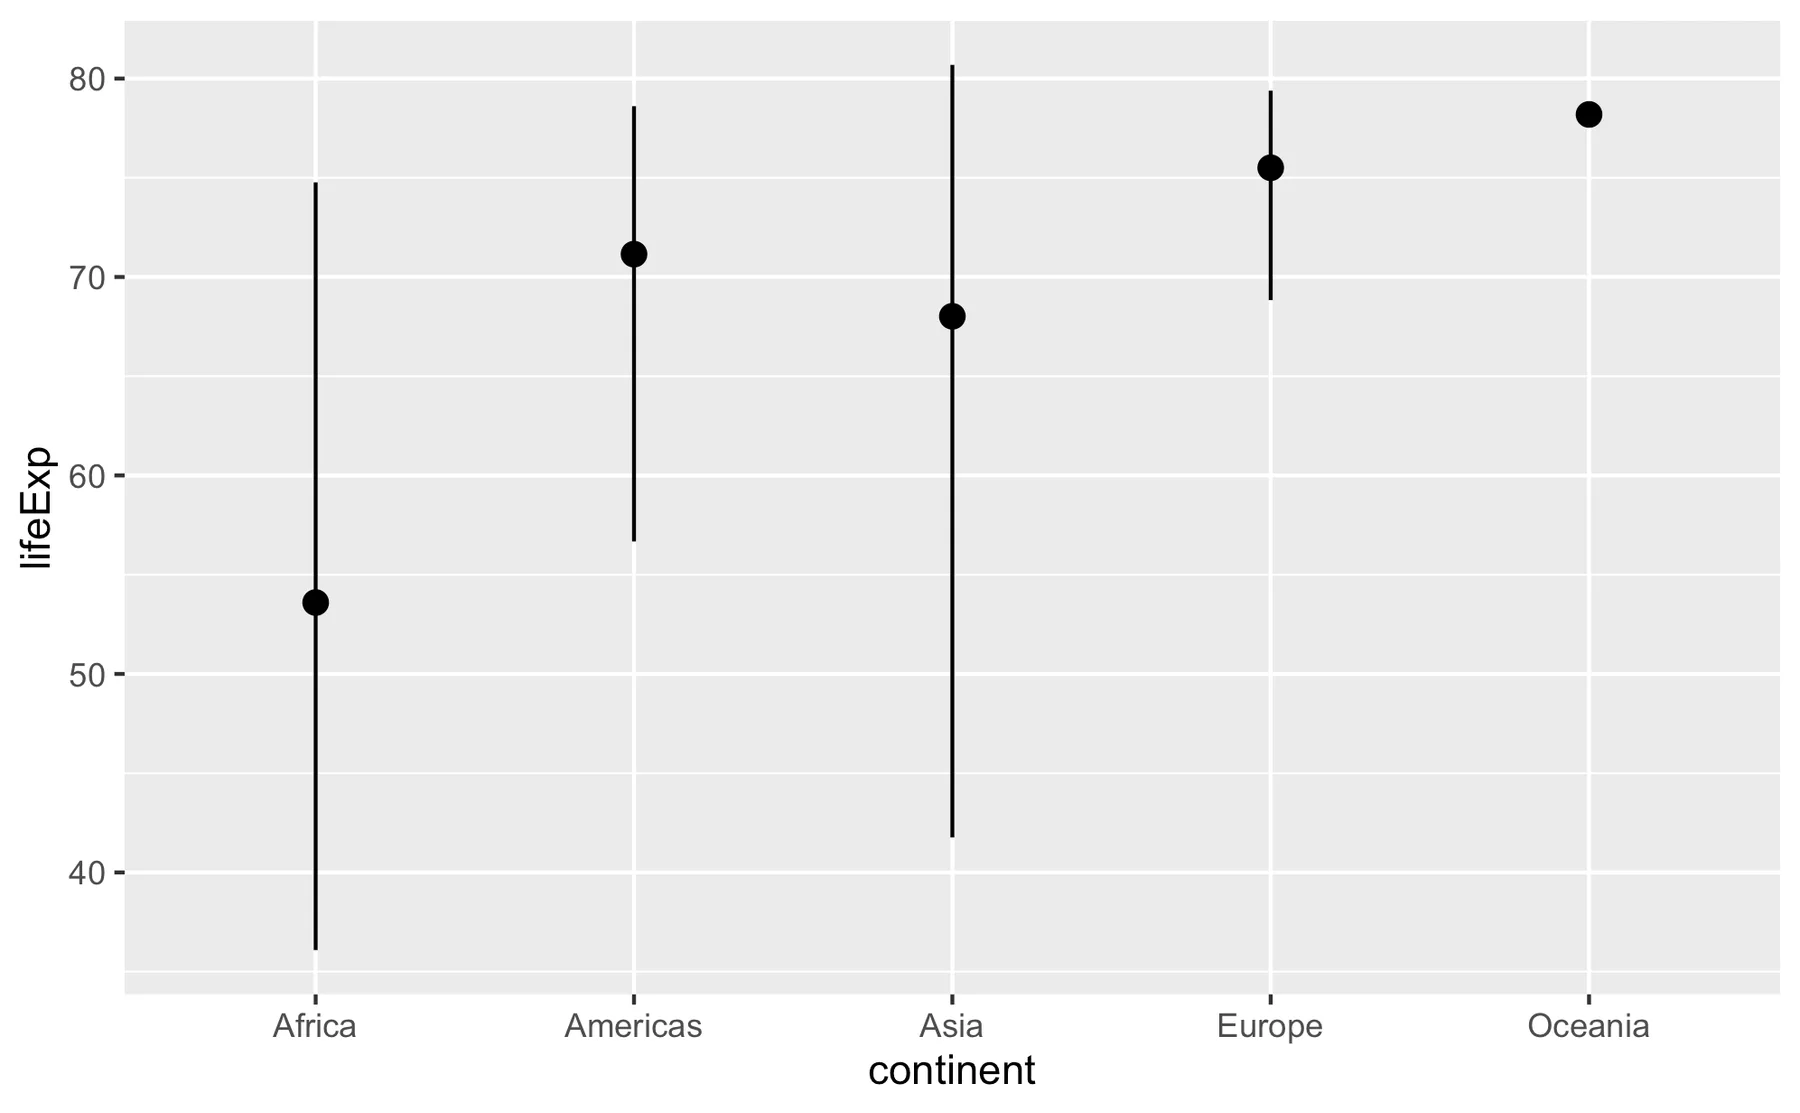
Vi kan också använda stat_summary() för att välja vilka parametrar som skall beräknas och visualiseras. Med stat_summary() har vi större flexibilitet avseende beräkningarna. Vi specificerar själva vilka funktioner som skall användas och vi väljer dessutom vilken typ av geom som skall illustrera resultatet. Här nedan använder vi stat_summary() för att beräkna medelvärde, minsta värde, största värde för förväntad livslängd på varje kontinent och detta visualiseras med geomet "pointrange" (geom_pointrange()):
## Vi använder bara data från 1997
ggplot(data = filter(gapminder, year==1997)) +
  stat_summary(
    aes(x = continent,
        y = lifeExp),
    fun = mean,
    fun.min = min,
    fun.max = max,
    geom = "pointrange"
  )
Segmenterade stapeldiagram
Vi återgår till mpg data för att illustrera ytterligare funktioner i geom_bar(). I nästa exempel använder vi fill för att markera andelar av en stapel. Vi vill markera andelar av kolumnen drv (bilens drivlina) i varje stapel. I koden nedan har vi även justerat grafens tema med funktionen theme() för att vinkla texten på x-axeln 45° (teman diskuteras i kommande kapitel).
mpg |>
  ggplot(aes(x=manufacturer,
             fill=drv)) +
  geom_bar() +
  # Ger texten på x-axeln 45° lutning
  theme(axis.text.x = element_text(angle=45))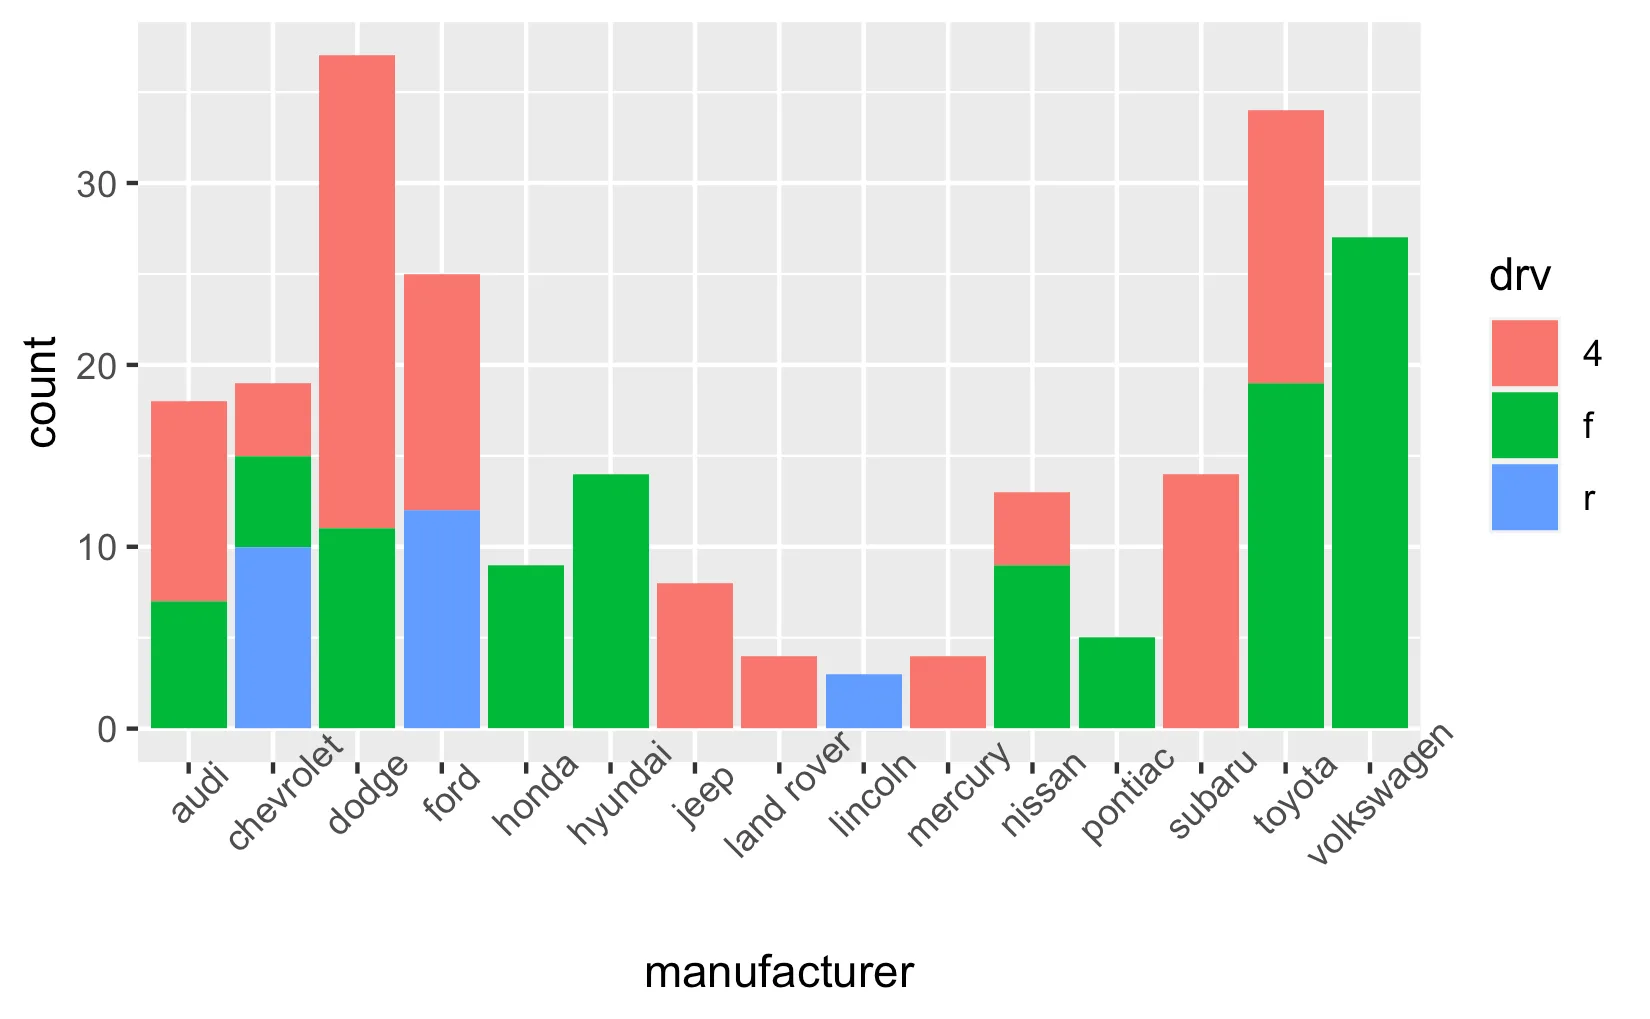
Det verkar som att tillverkaren Volkswagen endast tillverkar bilar med framhjulsdrift (f) medan Subaru endast tillverkar bilar med furhjulsdrift. Land Rover tillverkar endast bakhjulsdrivna bilar.
I exemplet ovan skrev vi geom_gar() utan några argument. Det innebär att position fick sitt defaultvärde som är "identity". Det finns även alternativen "dodge" och "fill", vilka resulterar i följande grafer:
mpg |>
  ggplot(aes(x=manufacturer,
             fill=drv)) +
  geom_bar(position="dodge") +
  theme(axis.text.x = element_text(angle=45))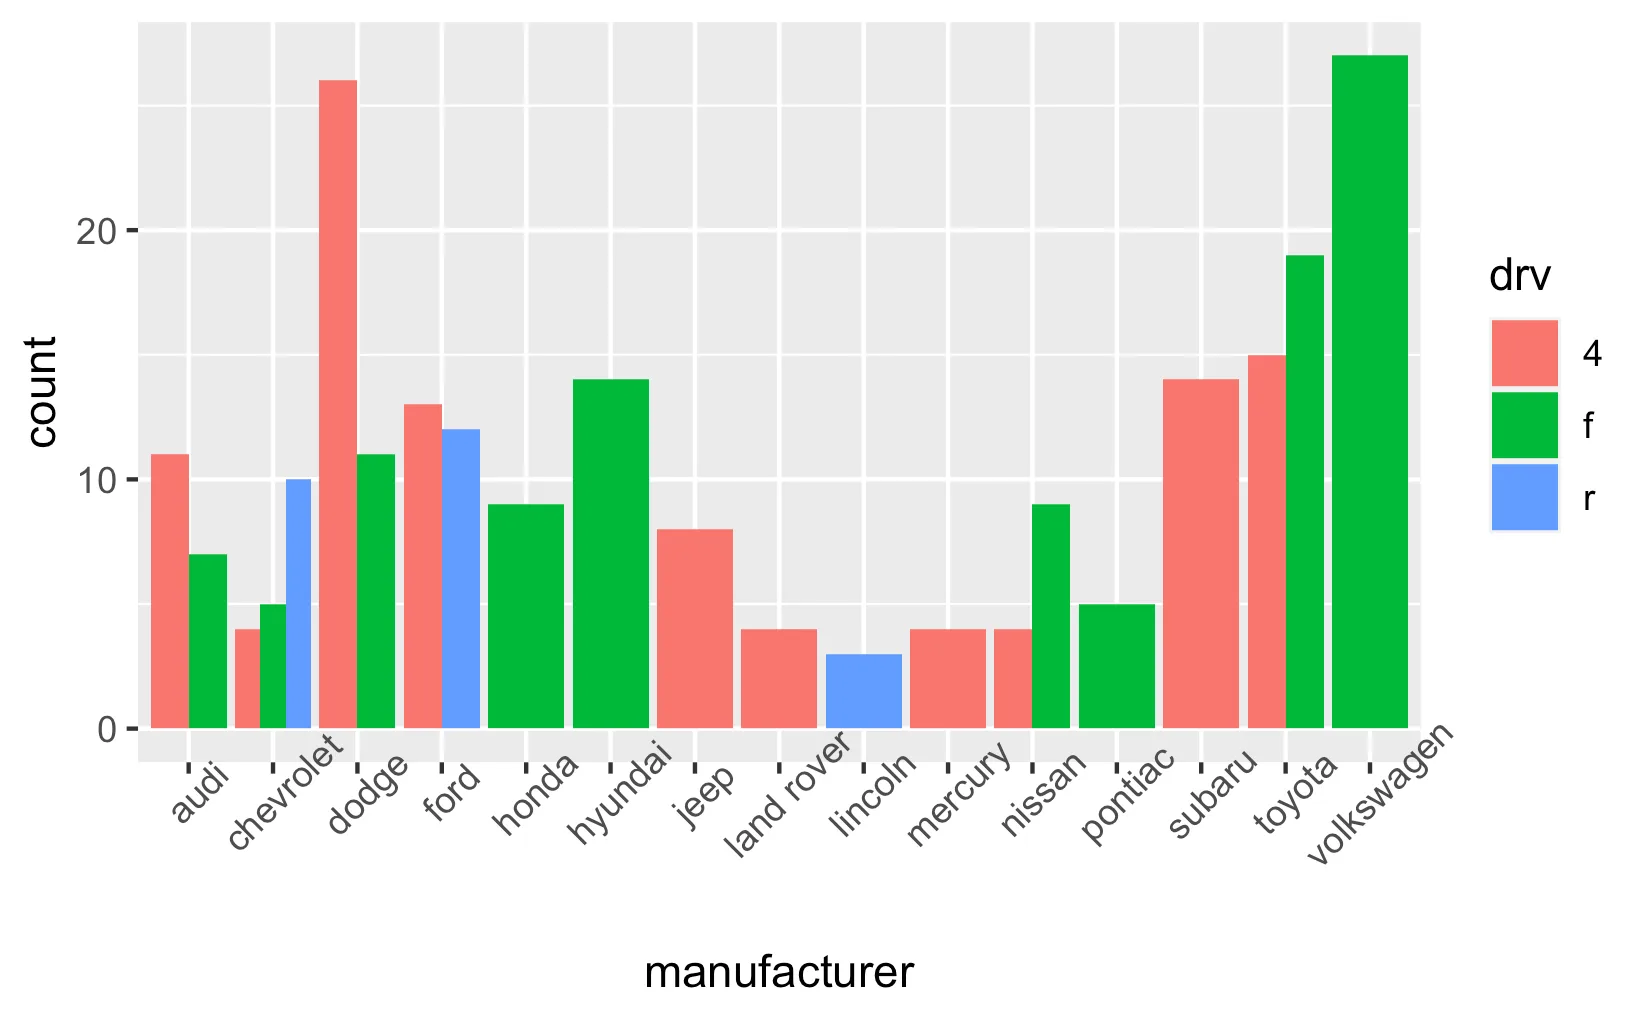
Som framgår ovan resulterar position="dodge" i att segmenten placeras bredvid varandra istället för att staplas på varandra. Vi fortsätter med position="fill":
mpg |>
  ggplot(aes(x=manufacturer,
             fill=drv)) +
  geom_bar(position="fill") +
  theme(axis.text.x = element_text(angle=45))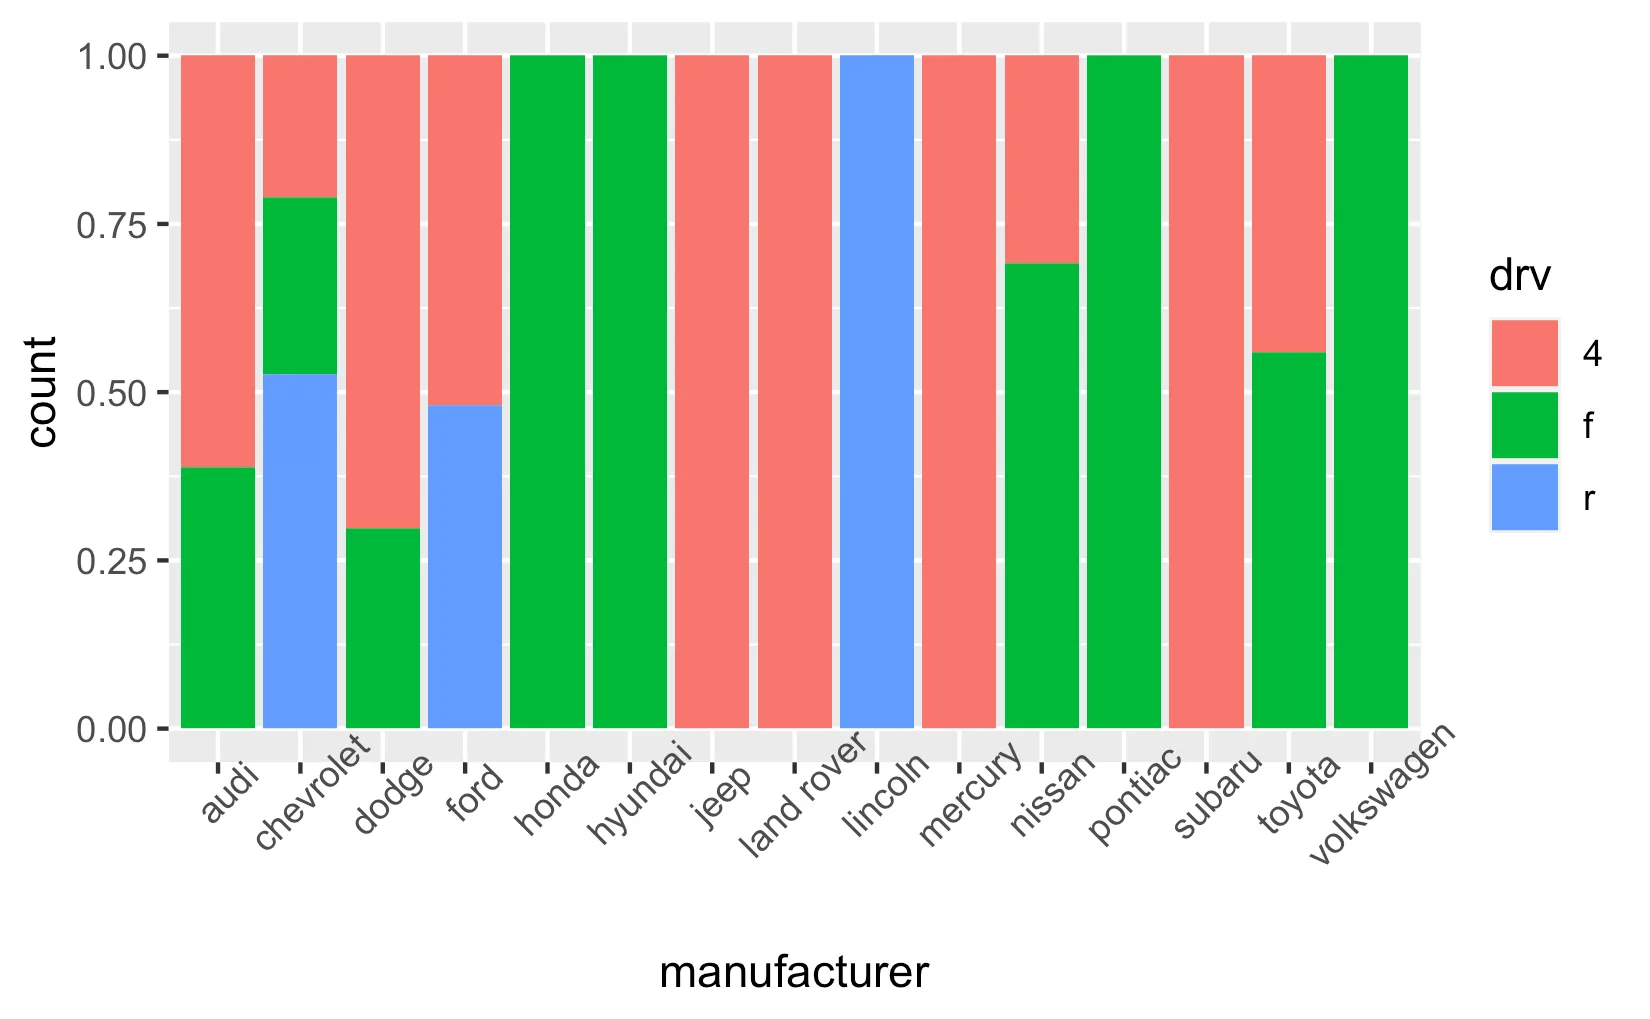
Som framgår ovan resulterar position="fill" i att segmenten i varje stapel presenteras som andelar (proportioner) istället för antal.