Övningsdata
I detta kapitel använder vi data från gapminder. Gapminder grundades i Stockholm år 2005 och samlar global statistik om bland annat hälsa, ekonomisk utveckling och populationsutveckling. Du kan få åtkomst till data från Gapminder med följande kommandon:
install.packages("gapminder")
library(gapminder)
gapminder
I Gapminder finns variablerna country, continent, year, lifeExp (livslängd), pop (populationsmängd) och gdpPercap (GDP per capita). Dessa data är våra övningsdata.
| country | continent | year | lifeExp | pop | gdpPercap |
|---|---|---|---|---|---|
| Afghanistan | Asia | 1952 | 28.80100 | 8425333 | 779.4453 |
| Afghanistan | Asia | 1957 | 30.33200 | 9240934 | 820.8530 |
| Afghanistan | Asia | 1962 | 31.99700 | 10267083 | 853.1007 |
| Afghanistan | Asia | 1967 | 34.02000 | 11537966 | 836.1971 |
| Afghanistan | Asia | 1972 | 36.08800 | 13079460 | 739.9811 |
| Afghanistan | Asia | 1977 | 38.43800 | 14880372 | 786.1134 |
| Afghanistan | Asia | 1982 | 39.85400 | 12881816 | 978.0114 |
| Afghanistan | Asia | 1987 | 40.82200 | 13867957 | 852.3959 |
| Afghanistan | Asia | 1992 | 41.67400 | 16317921 | 649.3414 |
| Afghanistan | Asia | 1997 | 41.76300 | 22227415 | 635.3414 |
| Afghanistan | Asia | 2002 | 42.12900 | 25268405 | 726.7341 |
| Afghanistan | Asia | 2007 | 43.82800 | 31889923 | 974.5803 |
| Albania | Europe | 1952 | 55.23000 | 1282697 | 1601.0561 |
| Albania | Europe | 1957 | 59.28000 | 1476505 | 1942.2842 |
| Albania | Europe | 1962 | 64.82000 | 1728137 | 2312.8890 |
| Albania | Europe | 1967 | 66.22000 | 1984060 | 2760.1969 |
| Albania | Europe | 1972 | 67.69000 | 2263554 | 3313.4222 |
| Albania | Europe | 1977 | 68.93000 | 2509048 | 3533.0039 |
| Albania | Europe | 1982 | 70.42000 | 2780097 | 3630.8807 |
| Albania | Europe | 1987 | 72.00000 | 3075321 | 3738.9327 |
| Albania | Europe | 1992 | 71.58100 | 3326498 | 2497.4379 |
| Albania | Europe | 1997 | 72.95000 | 3428038 | 3193.0546 |
| Albania | Europe | 2002 | 75.65100 | 3508512 | 4604.2117 |
| Albania | Europe | 2007 | 76.42300 | 3600523 | 5937.0295 |
Paketet ggplot2 har en övergripande funktion: ggplot(). Vi börjar med att skriva ggplot() och ange argumentet data. När den koden körs erhåller vi följande figur.
ggplot(data=gapminder)
Ovan ser vi bara en tom grå rektangel, vilket beror på att grafen saknar två komponenter:
- Estetisk mappning:
aes() - Geometriska komponenter:
geom()
Vi fortsätter genom att lägga till aes(), där vi anger att x är year och y är pop. Resultatet är fortsatt en tom graf men nu med x-axel och y-axel specificerad:
ggplot(data=gapminder,
       aes(x=year,
           y=pop))
Grafen är tom eftersom den saknar geom(), vilket definierar geometriska komponenter. Vi lägger till geom_points() som specificerar att vi vill se punkter på grafen:
ggplot(data=gapminder,
       aes(x=year,
           y=pop)) +
  geom_point()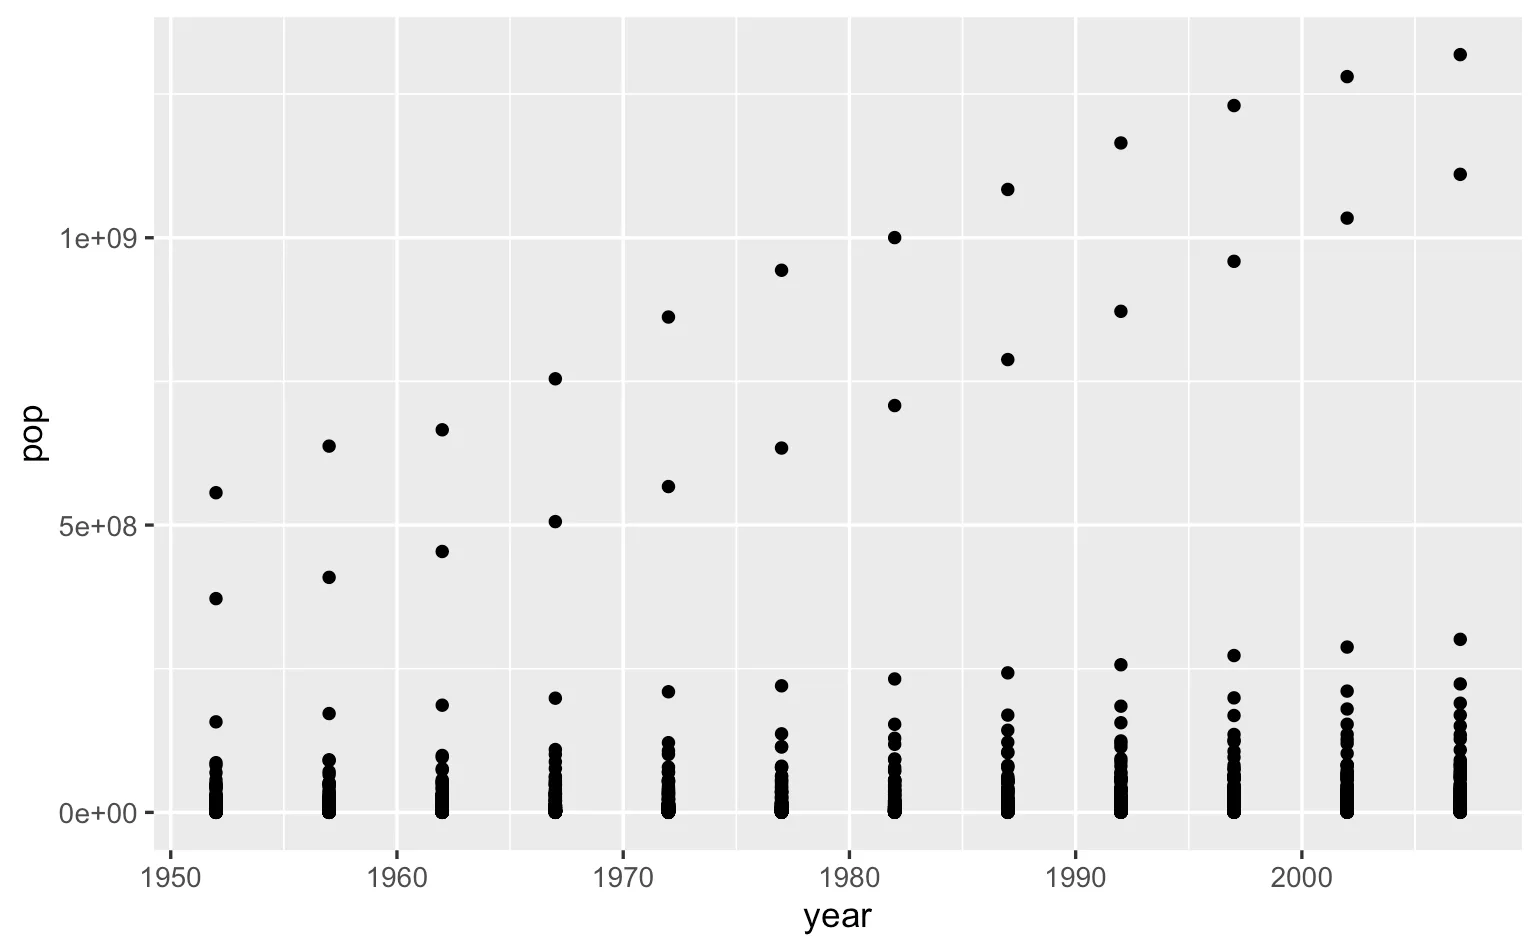
Det betyder att man i ggplot() specificerar en datakälla, estetiska mappning (aes()) med bland annat x-axel och y-axel, och därefter adderar lager med geometriska komponenter (exempelvis geom_point()). Således har geom_point() ärvt den estetiska mappningen från ggplot()!
Labels (etiketter)
Etiketter förtydligar grafens innehåll. Den engelska termen är labels, som hädanefter också används här. Labels anges med funktionen labs(). Du kan ange labels för x-axel, y-axel, titel, subtitel, figurförklaring, osv. Exempel följer:
ggplot(data=gapminder,
       aes(x=year,
           y=pop)) +
  geom_point() +
  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.")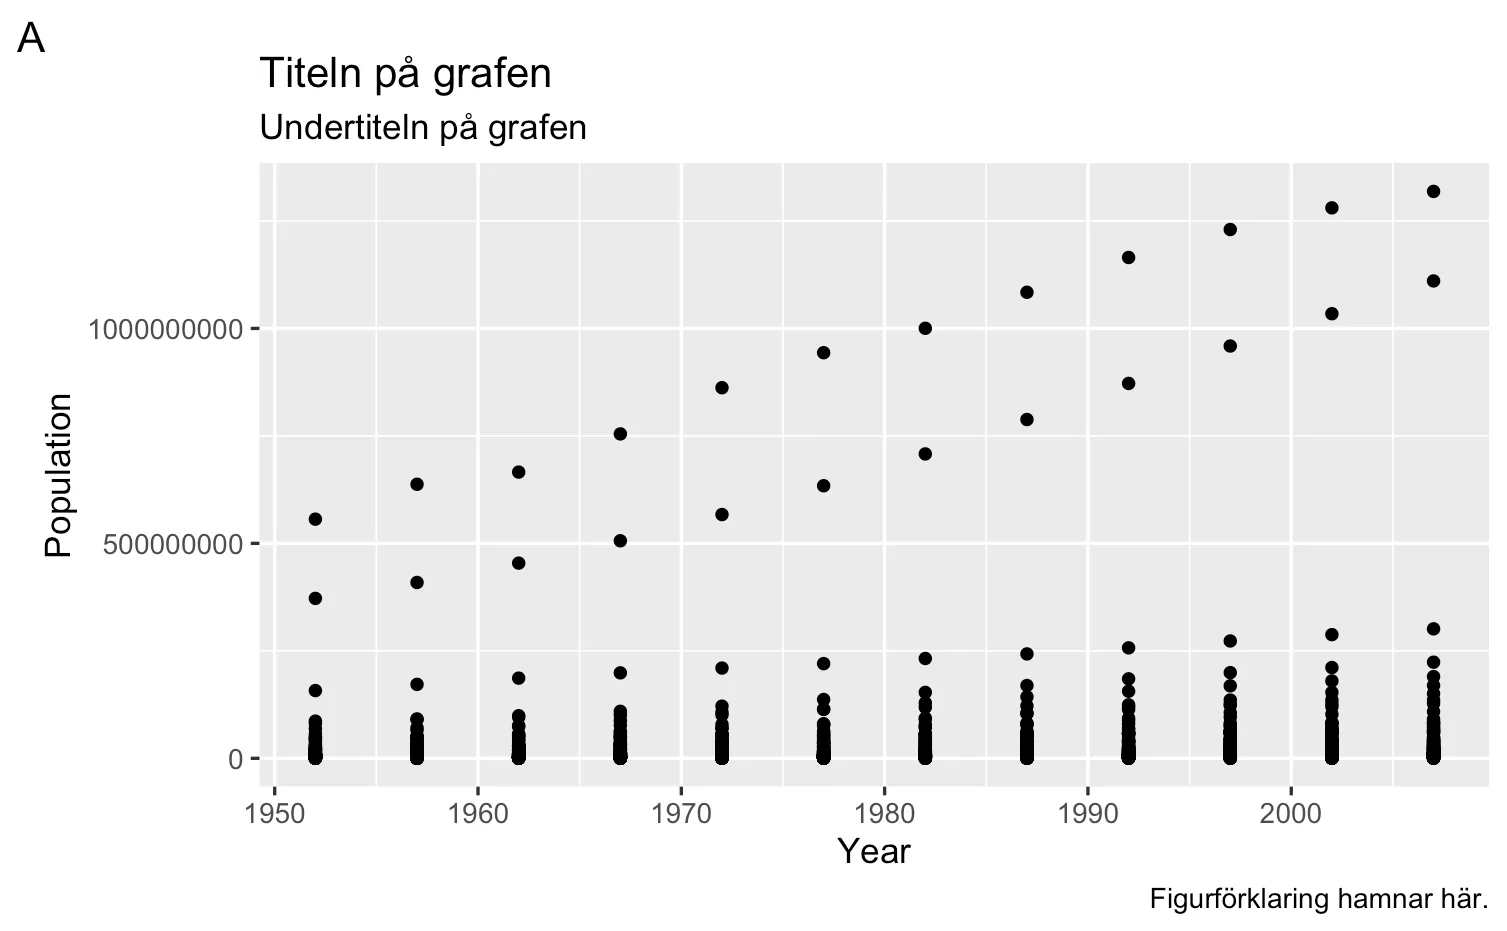
Det börjar bli ett par rader kod nu. För att det skall vara tydligt vad som är nytt i varje kodruta kommer det hädanefter markeras med kommentaren #NYTT.
Inaktivera Scientific notation
Notera y-axeln på föregående graf. Värdena är presenterade med scientific notation, vilket aktiveras på väldigt stora eller väldigt små tal. Du kan inaktivera detta med kommandot:
options(scipen=999)
Som nämnt ovan ärver geom_point() den estetiska mappningen (aes()) av ggplot(). Vi kan dock åsidosätta denna mappningen genom att ange aes() i geom_point(). Då kommer geom_point() inte ärva mappningen. Följande graf är alltså identisk med den föregående:
ggplot(data=gapminder) +
  # NYTT
  geom_point(aes(x=year,
                 y=pop)) +
  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.")
Att definiera den estetiska mappningen högst upp är fördelaktigt eftersom man slipper upprepa mappningen i varje geom().
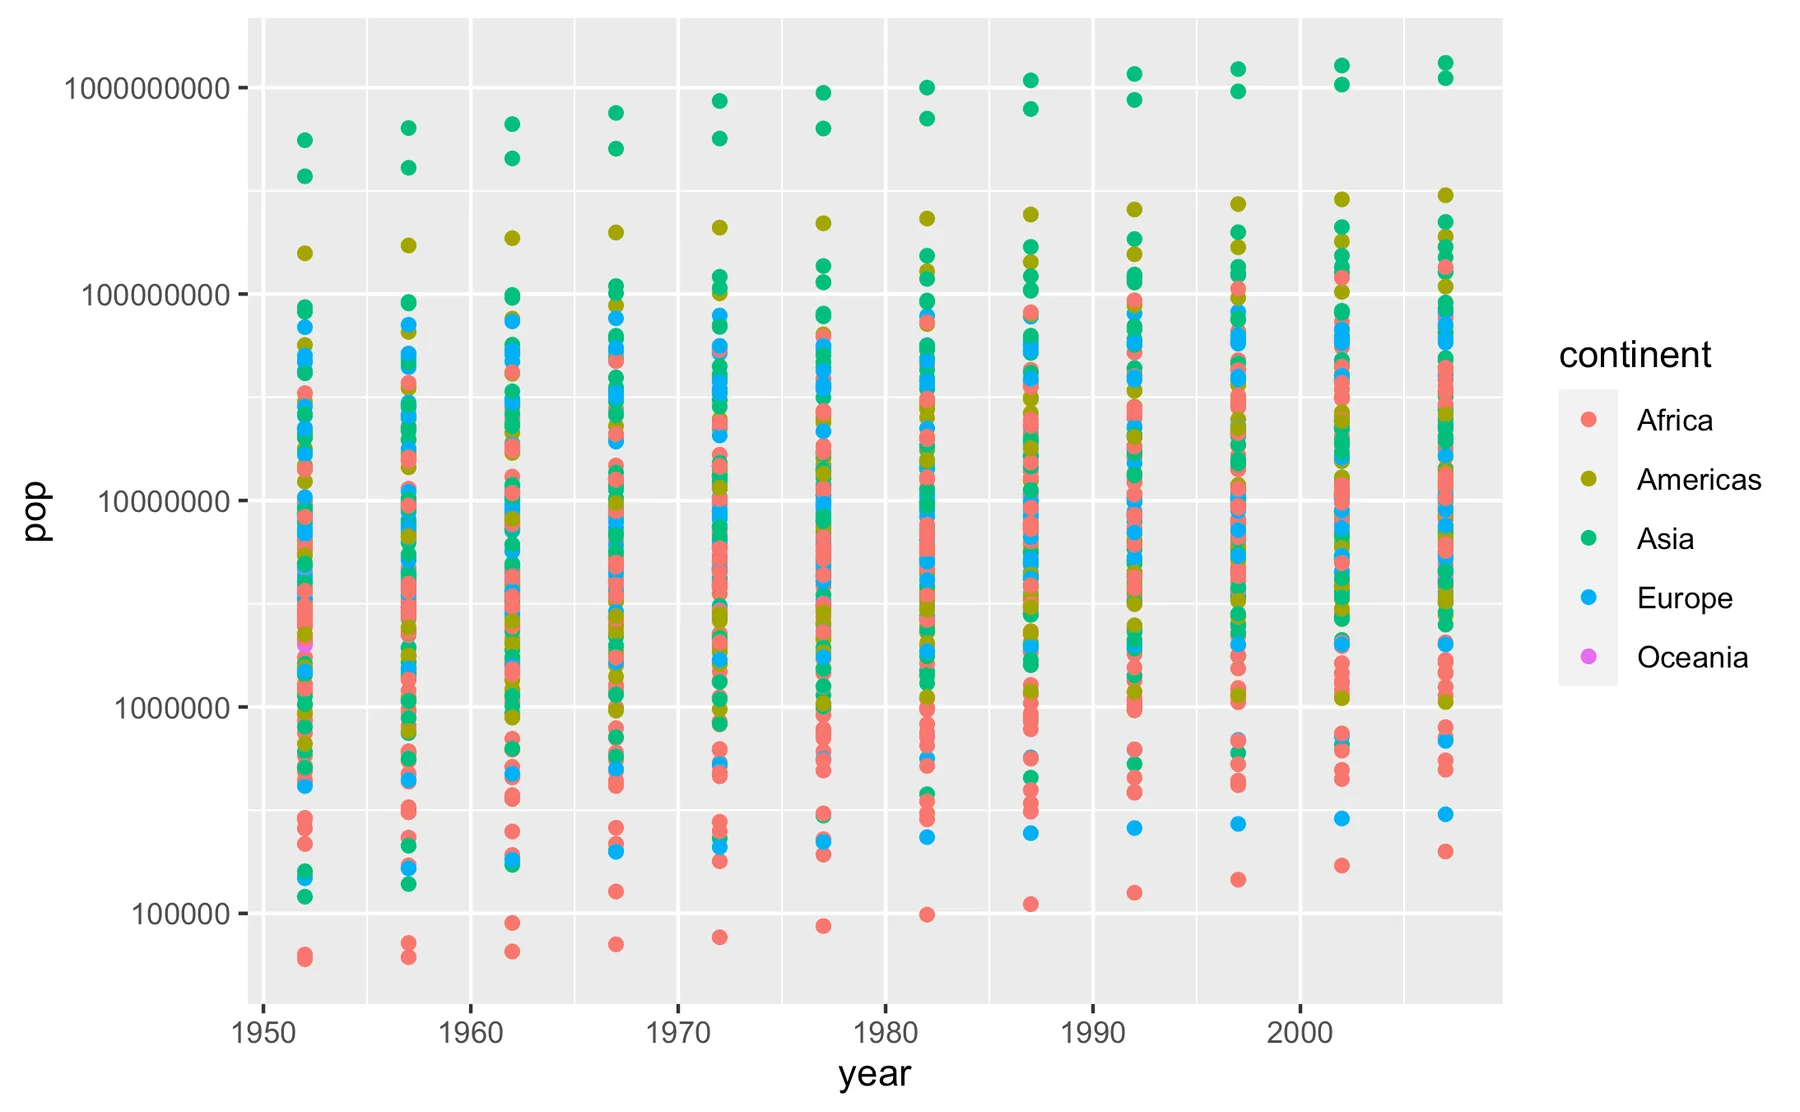
Låt oss färga punkterna baserat på kontinenten de tillhör. Detta görs i aes() genom att specificera att color=continent:
ggplot(data=gapminder, aes(x=year,
                           y=pop,
                           # NYTT
                           color=continent)) +
  geom_point() +
  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.")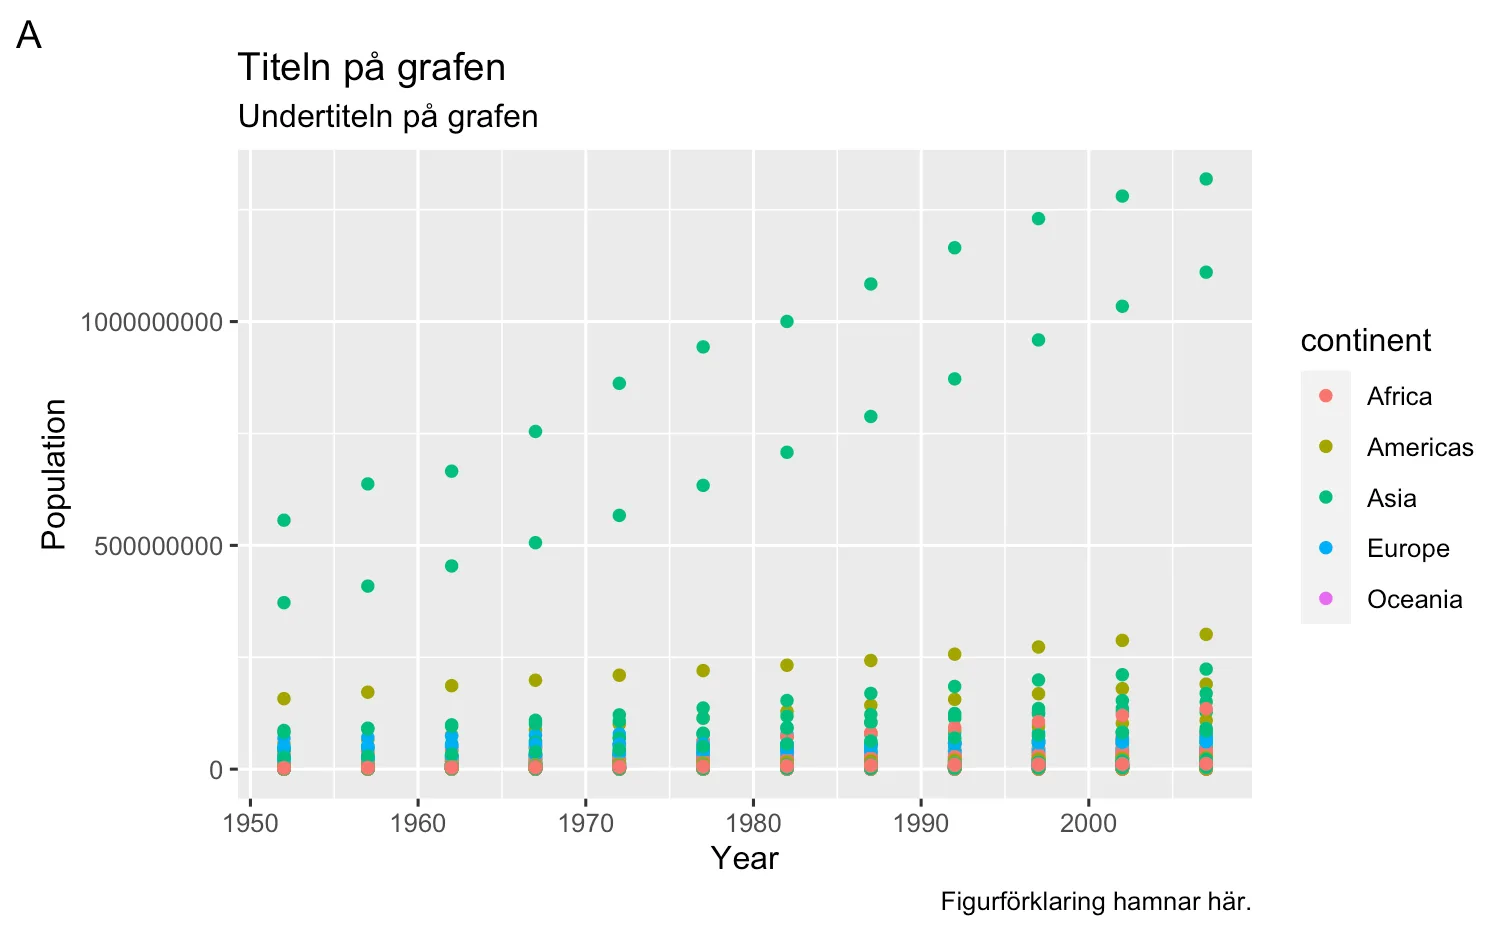
Till höger om grafen finns färgkodningen, vars label "continent" behöver justeras. Man kan ange en label i labs() med argumentet color.
ggplot(data=gapminder, aes(x=year,
                           y=pop,
                           color=continent)) +
  geom_point() +
  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.",
       # NYTT
       color="Kontinent")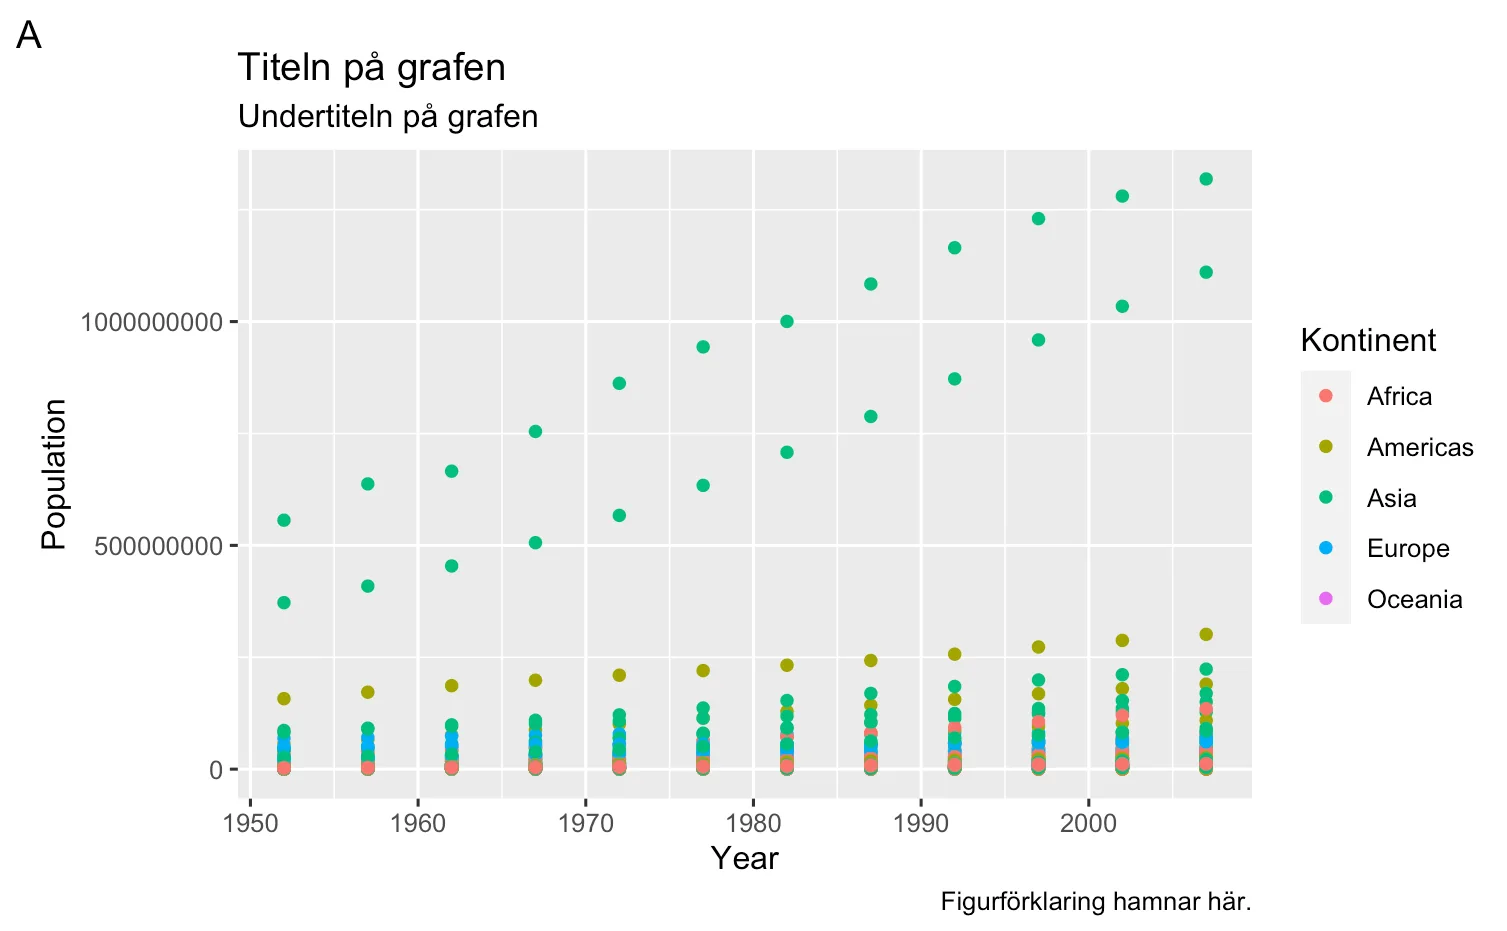
I gapminder finns flera rader för varje land. I nästa steg ska vi summera befolkningsmängden i varje kontinent varje kalenderår. För att göra detta använder vi dplyr enligt följande:
gapminder_summary <- gapminder |>
  # Gruppera på continent och year
  group_by(continent, year) |>
  # Beräkna summan av pop (för varje kontinent och år)
  summarise(population = sum(pop)) |>
  # Inaktivera grupperingen i data framen
  ungroup()

## Se data
gapminder_summary| continent | year | population |
|---|---|---|
| Africa | 1952 | 237640501 |
| Africa | 1957 | 264837738 |
| Africa | 1962 | 296516865 |
| Africa | 1967 | 335289489 |
| Africa | 1972 | 379879541 |
| Africa | 1977 | 433061021 |
| Africa | 1982 | 499348587 |
| Africa | 1987 | 574834110 |
| Africa | 1992 | 659081517 |
| Africa | 1997 | 743832984 |
| Africa | 2002 | 833723916 |
| Africa | 2007 | 929539692 |
| Americas | 1952 | 345152446 |
| Americas | 1957 | 386953916 |
| Americas | 1962 | 433270254 |
| Americas | 1967 | 480746623 |
| Americas | 1972 | 529384210 |
Låt oss beräkna den totala populationen på varje kontinent varje kalenderår:
ggplot(gapminder_summary,
       aes(x=year,
       y=population,
       color=continent)) +
  geom_point()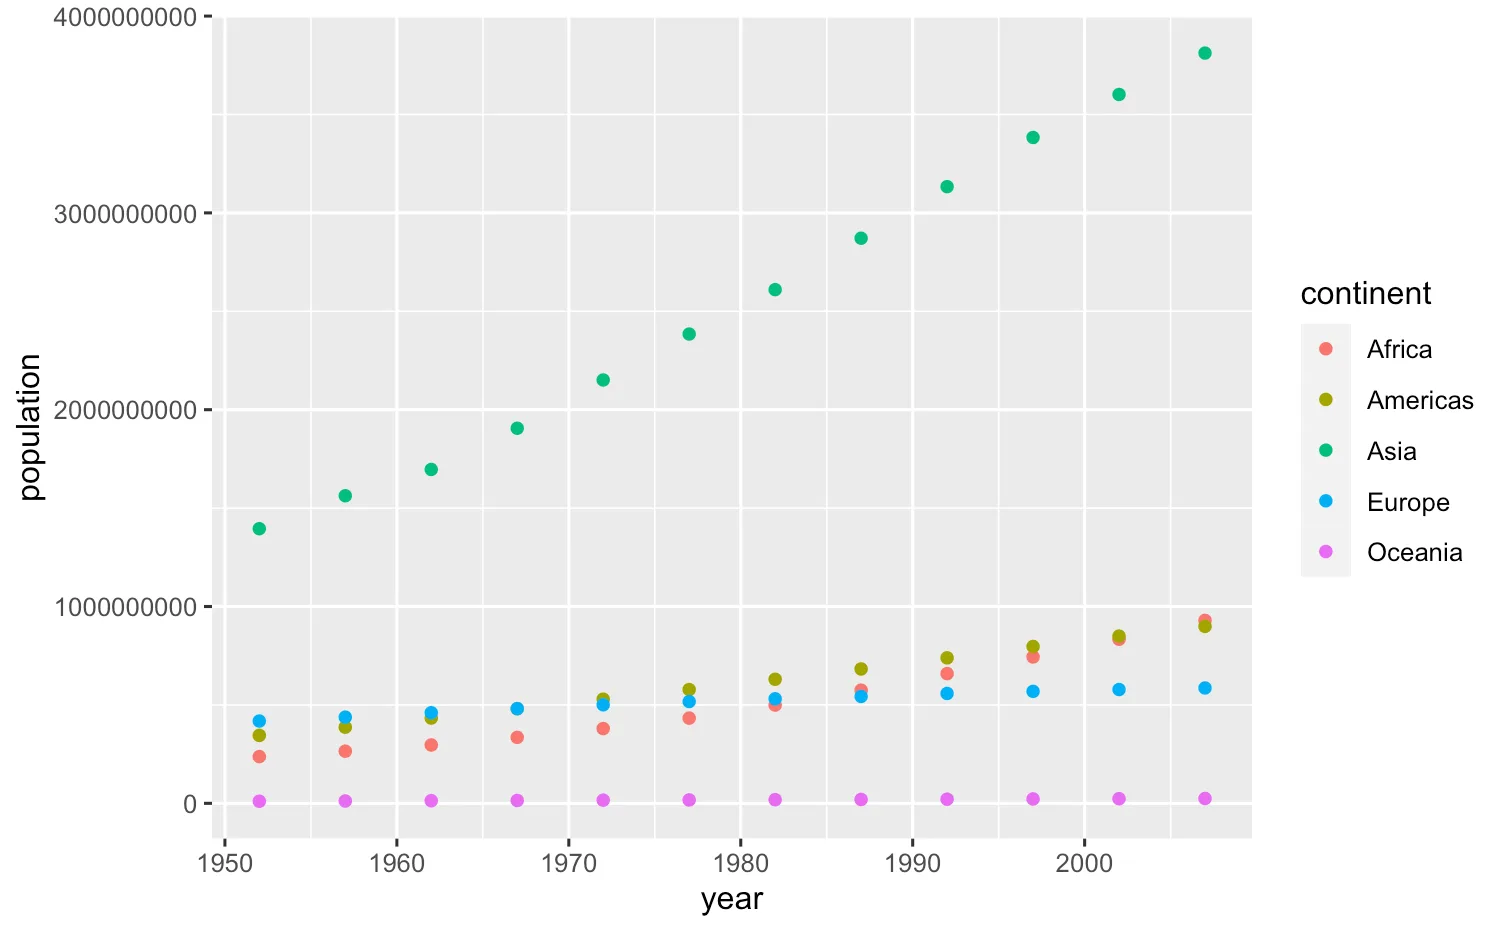
Vi adderar en linje mellan punkterna för att tydligare se trenden:
ggplot(gapminder_summary,
       aes(x=year, y=population, color=continent)) +
  geom_point() +
  # NYTT
  geom_line()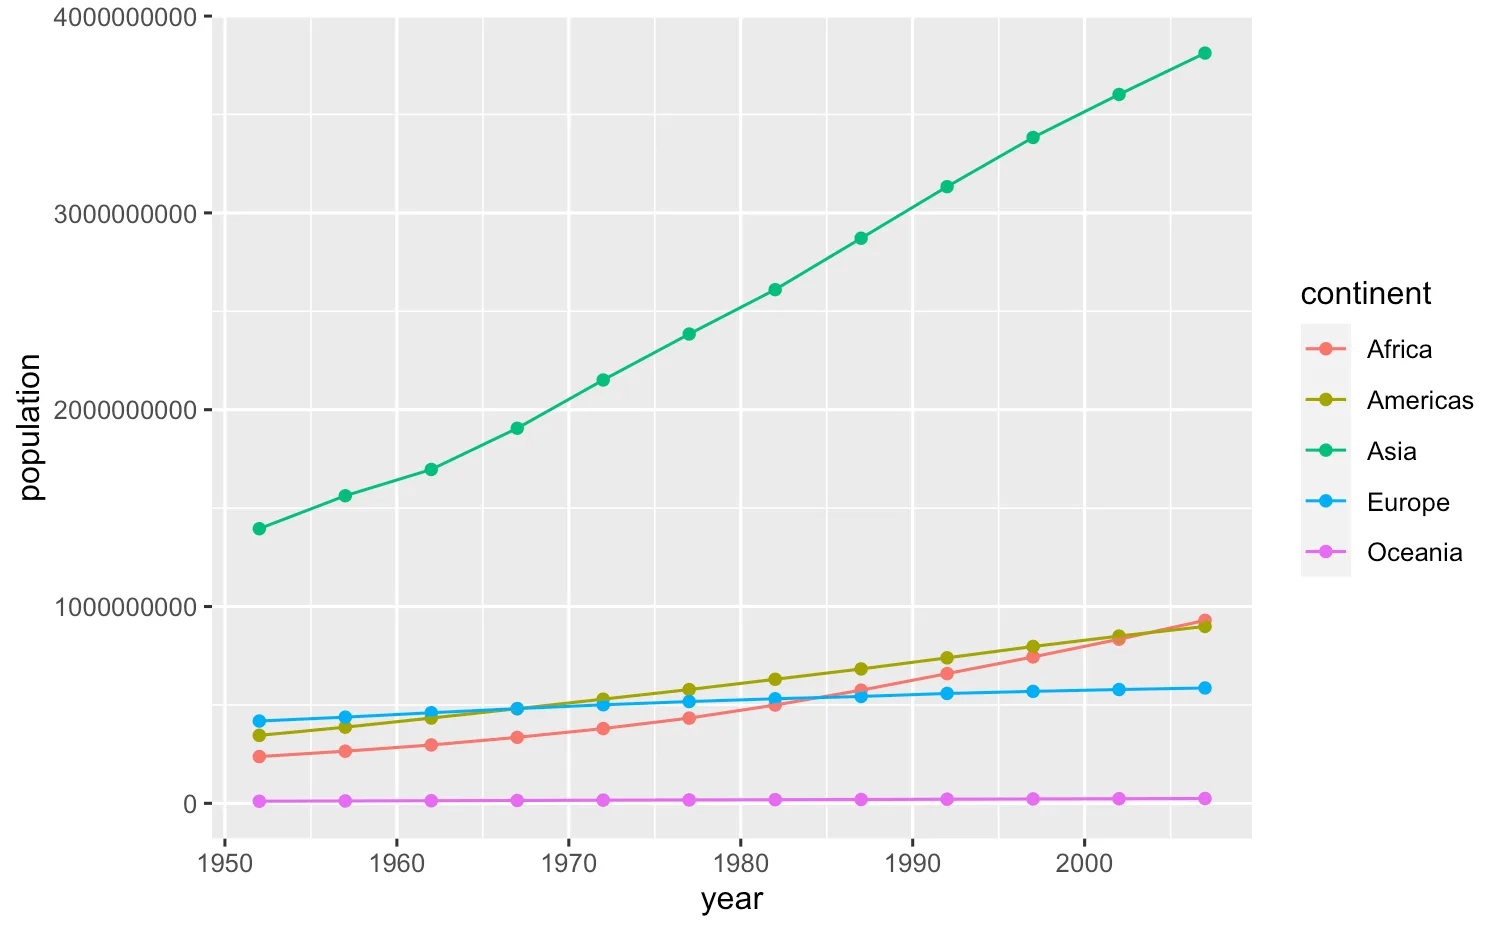
Med geom_text() kan du lägga till text. Nu adderar vi geom_text() för att visa befolkningsmängden på varje datapunkt. Även geom_text() har estetisk mappning. Här anger vi endast argumentet label som vi definierar som variabeln population. X-värdet och y-värdet för geom_text() kommer ärvas från ggplot().
ggplot(gapminder_summary,
       aes(x=year, y=population, color=continent)) +
  geom_point() +
  geom_line() +
  # NYTT
  geom_text(aes(label=population))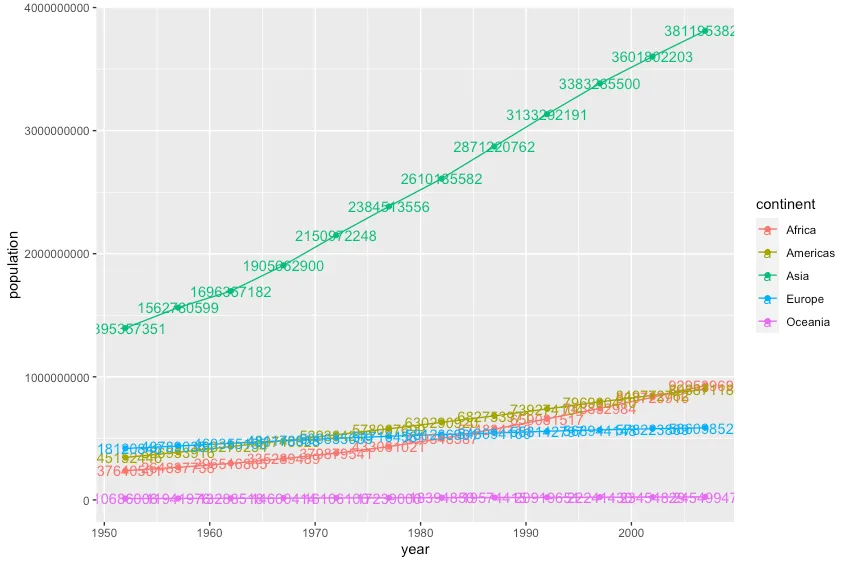
Vi gör om exakt samma procedur men med geom_label() istället för geom_text(). Med geom_label() ges texten en bakgrund som gör den synligare:
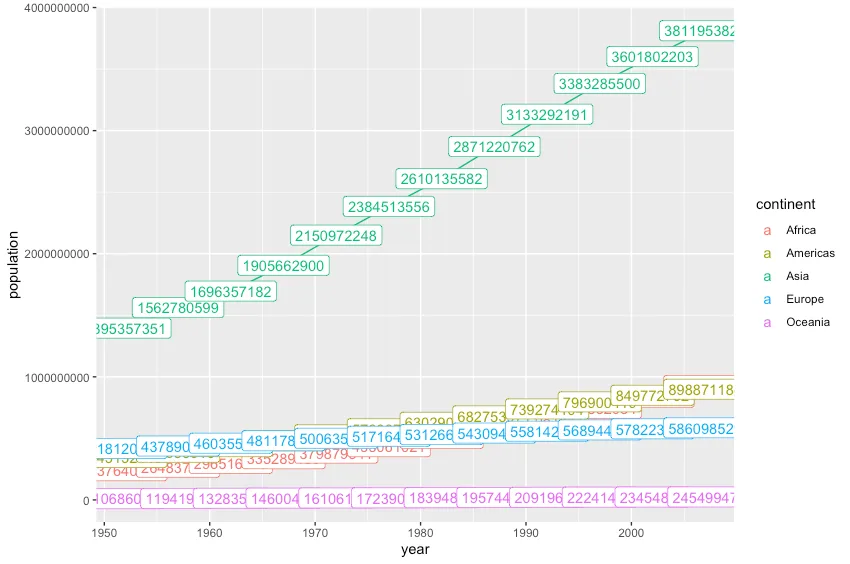
Båda ovanstående grafer är suboptimala eftersom labels är placerade för nära varandra. Vi behöver en funktion som automatiskt kan separarera labels. Detta finns i ggrepel-paketet, vars funktion geom_text_repel() automatiskt separarear text. Paketet avlägsnar datapunkter som inte kan visualiseras på ett rimligt vis. Resultat är som regel tillfredsställande:
install.packages("ggrepel")
library(ggrepel)ggplot(gapminder_summary,
aes(x=year, y=population, color=continent)) +
geom_point() +
geom_line() +
# NYTT
geom_text_repel(aes(label=population))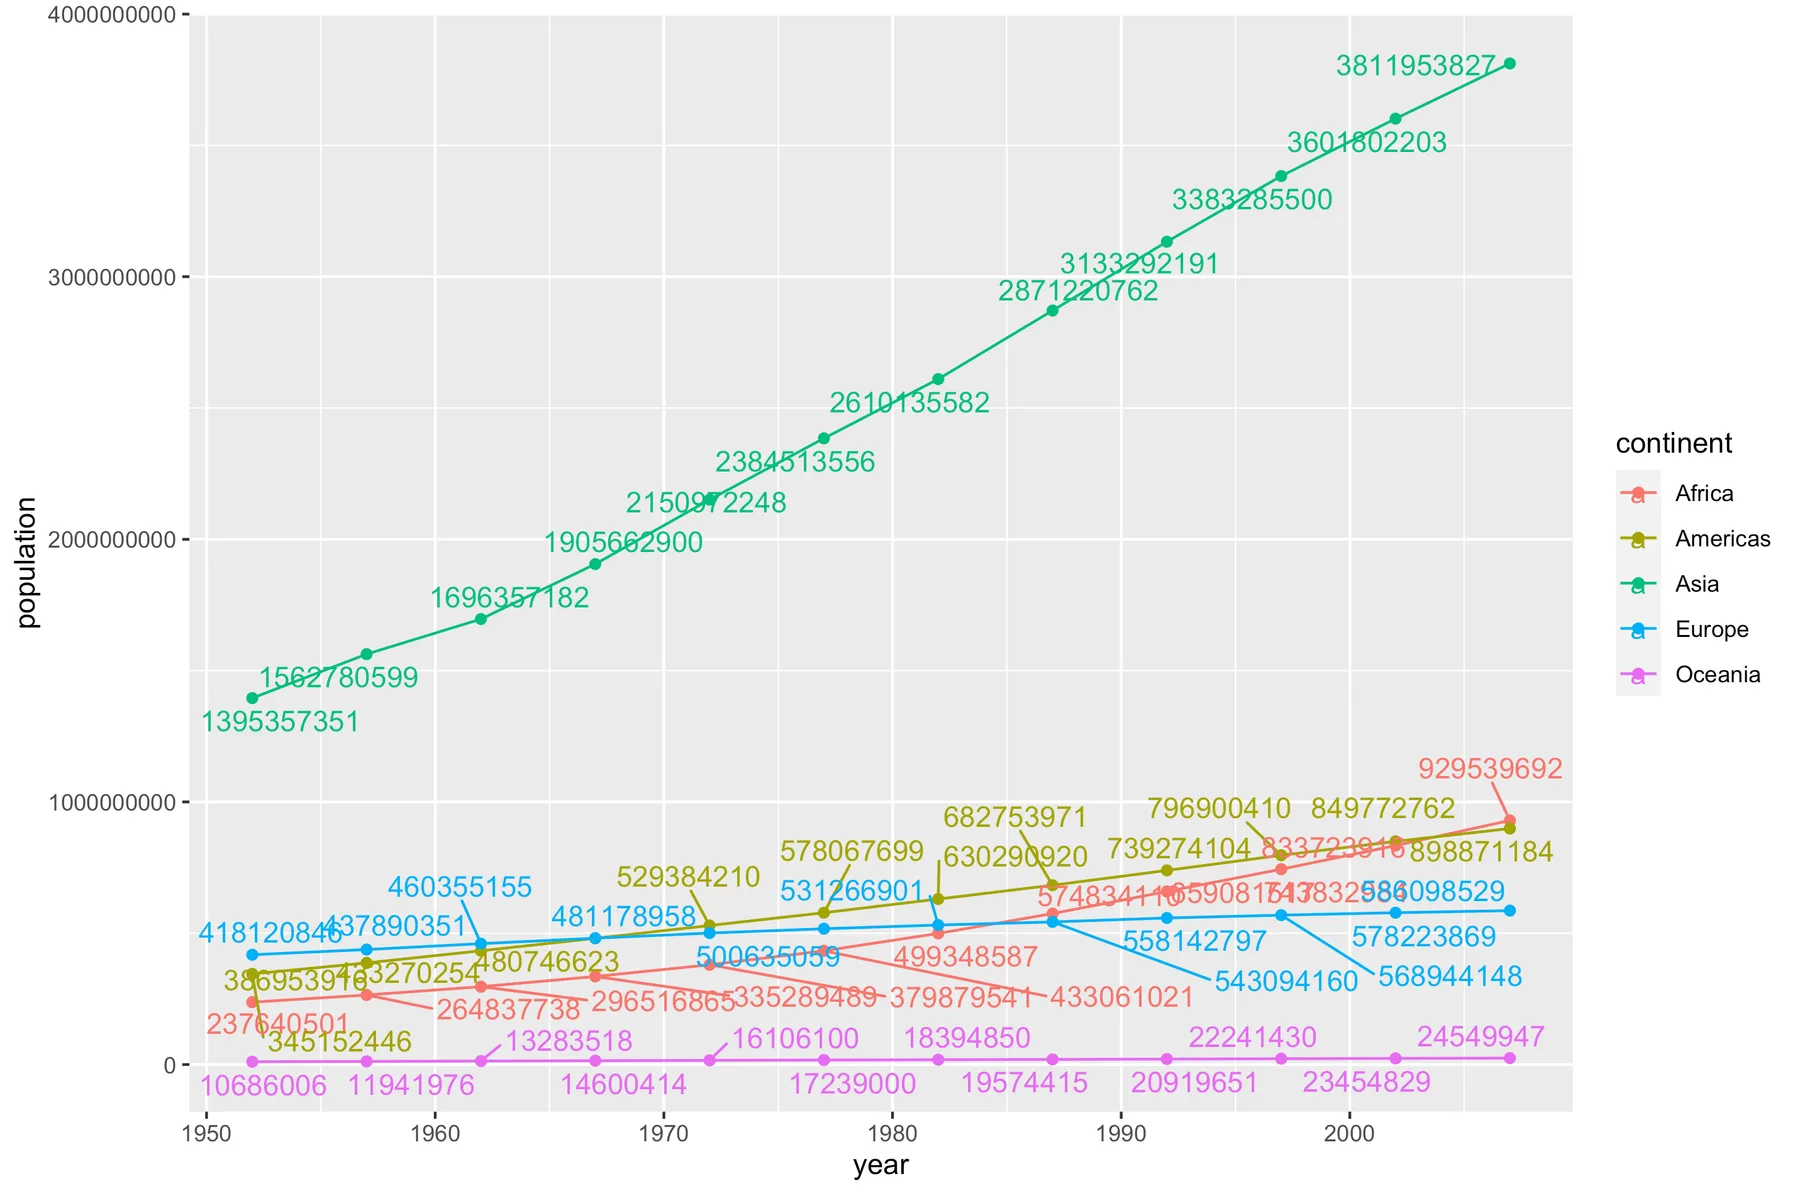
Det är fortfarande otydligt. Möjligtvis blir det tillräckligt informativt att bara redovisa siffrorna första och sista året. Detta kan göras geno att beräkna maximalt respektive minimalt antal människor på varje kontinent. Dessa beräkningar görs och skickas till objekten max_population och min_population, som sedan också används i ggplot():
## Beräknar varje kontinents största population
max_population <- gapminder_summary %>%
  group_by(continent) %>%
  arrange(continent, desc(population)) %>%
  distinct(continent, .keep_all = T)

## Beräknar varje kontinents insta population
min_population <- gapminder_summary %>%
  group_by(continent) %>%
  arrange(continent, population) %>%
  distinct(continent, .keep_all = T)

## Visualiserar
ggplot(gapminder_summary,
       aes(x=year, y=population, color=continent)) +
  geom_point() +
  # NYTT
  # Text för max-värden
  geom_label_repel(data=max_population,
                  aes(x=year, y=population, color=continent, label=population)) +
  # NYTT
  # Text för minimi-värden
  geom_label_repel(data=min_population,
                  aes(x=year, y=population, color=continent, label=population))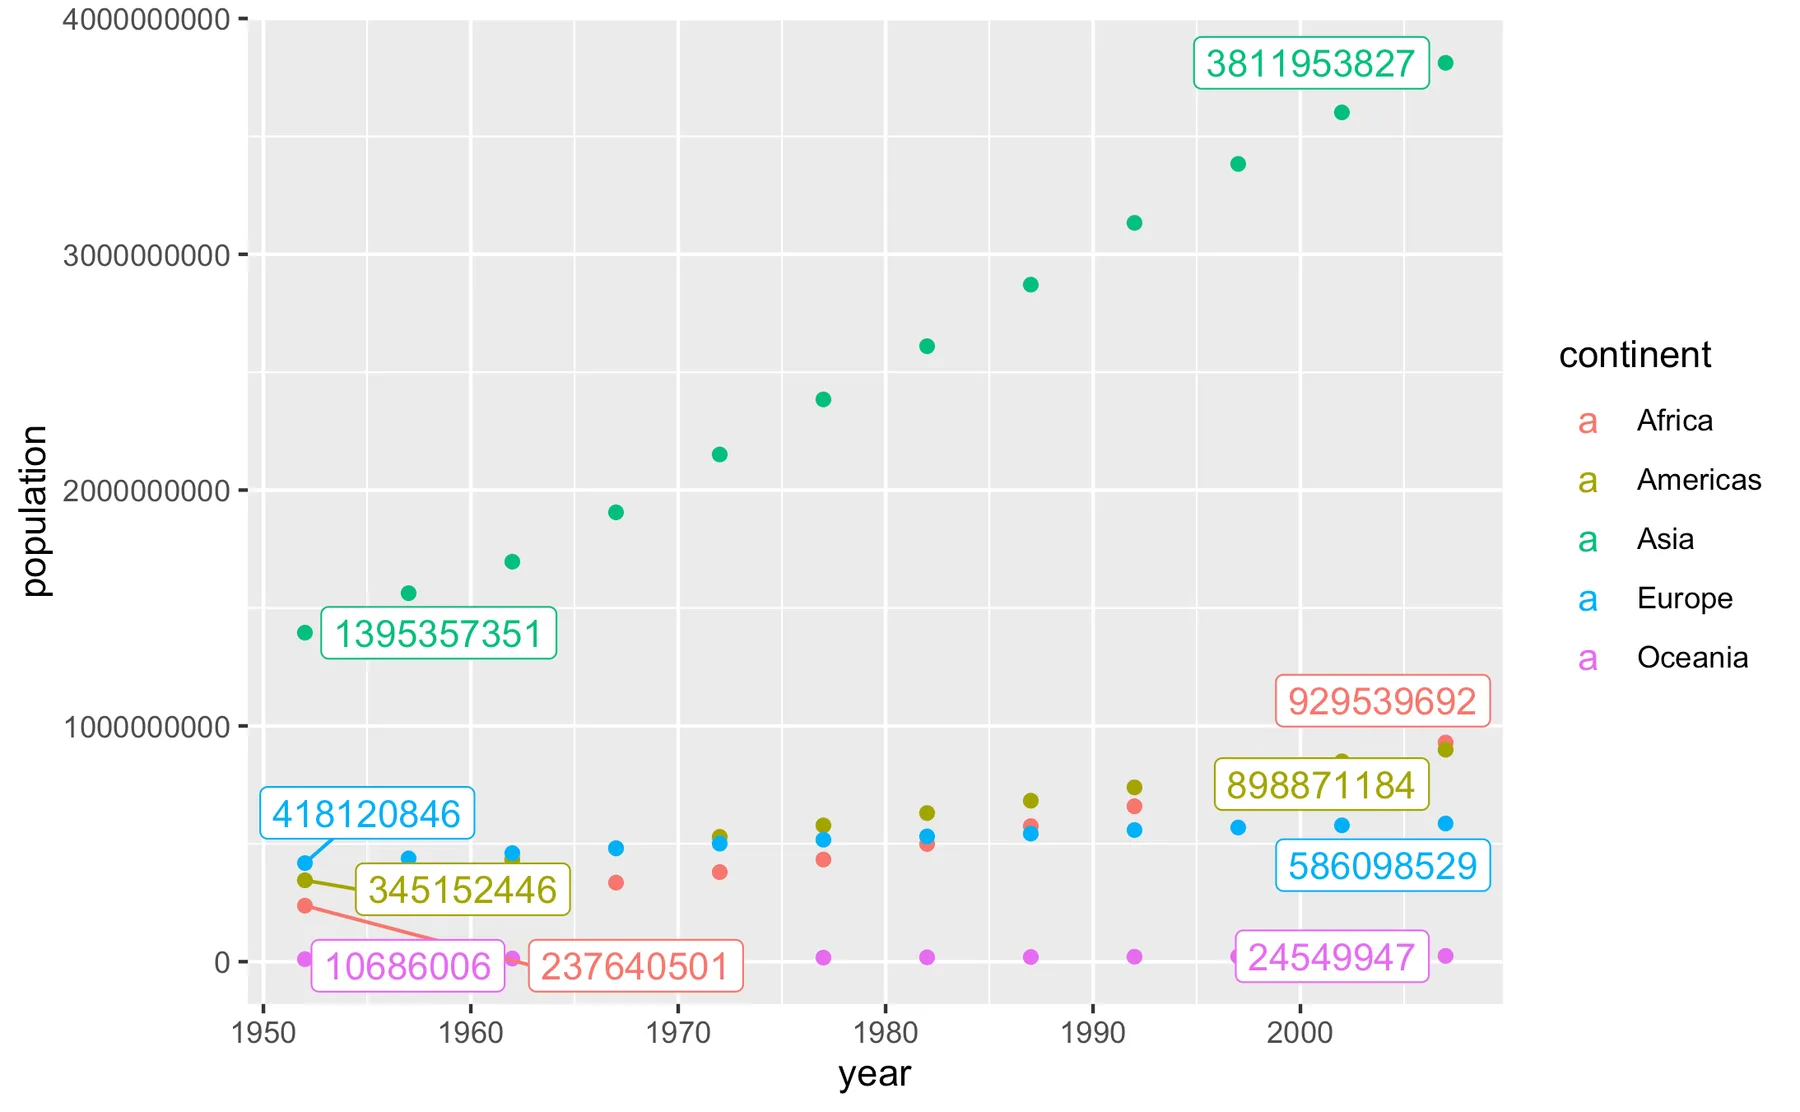
Vi ska nu använda geom_hline() och geom_vline() för att lägga till horisontella och vertikala referenslinjer. Dessa brukar placeras bakom datapunkterna, vilket innebär att de måste deklareras innan datapunkterna (geom_point()) i koden. Vi placerar linjer på två nivåer på y-axeln (specificeras med argumentet yintercept) enligt nedan:
ggplot(data=gapminder, aes(x=year,
                           y=pop,
                           color=continent)) +
  geom_point() +

  # NYTT
  geom_hline(aes(yintercept=1000000000)) +
  geom_hline(aes(yintercept=500000000)) +

  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.")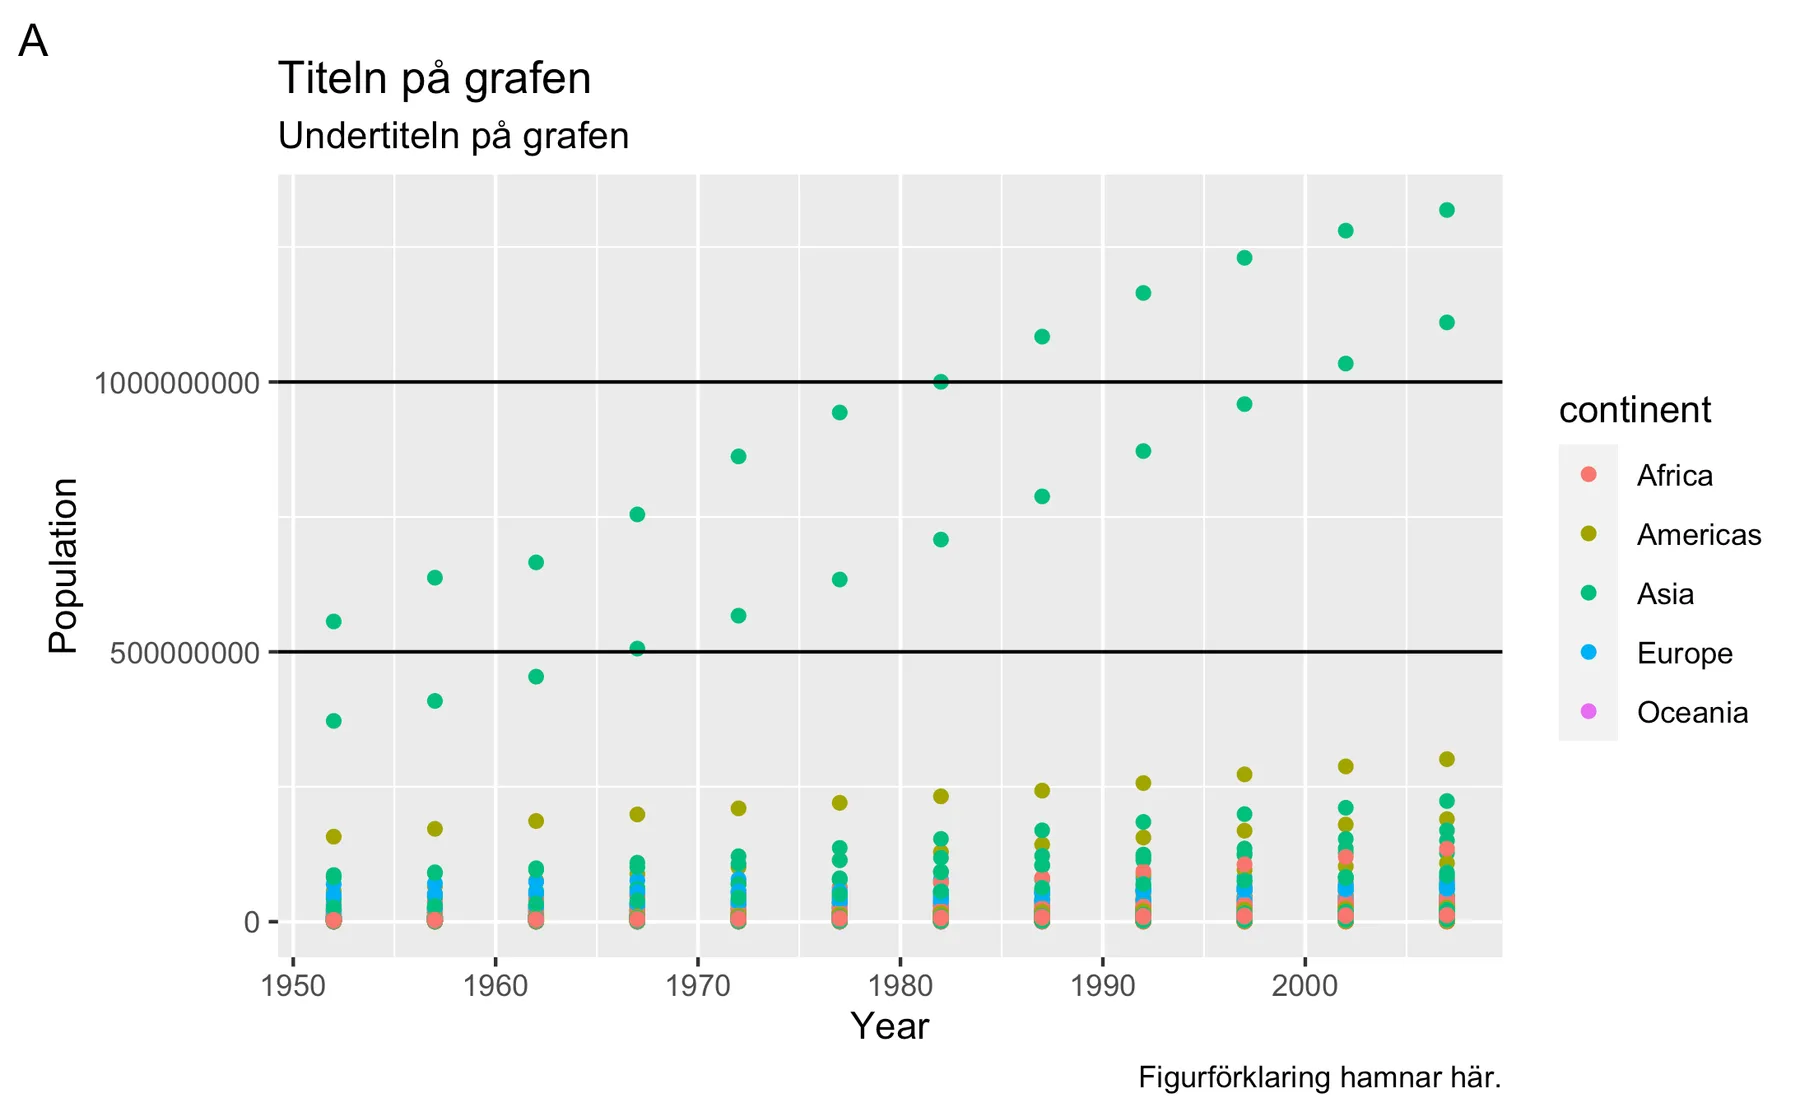
Med geom_rect() kan ett fält definieras, enligt följande:
ggplot(data=gapminder, aes(x=year,
                           y=pop,
                           color=continent)) +
  # NYTT
  geom_rect(aes(xmin=1960, xmax=1990, ymin=500000000, ymax=100000000)) +

  geom_point() +

  labs(x="Year",
       y="Population",
       tag="A",
       title="Titeln på grafen",
       subtitle="Undertiteln på grafen",
       caption="Figurförklaring hamnar här.")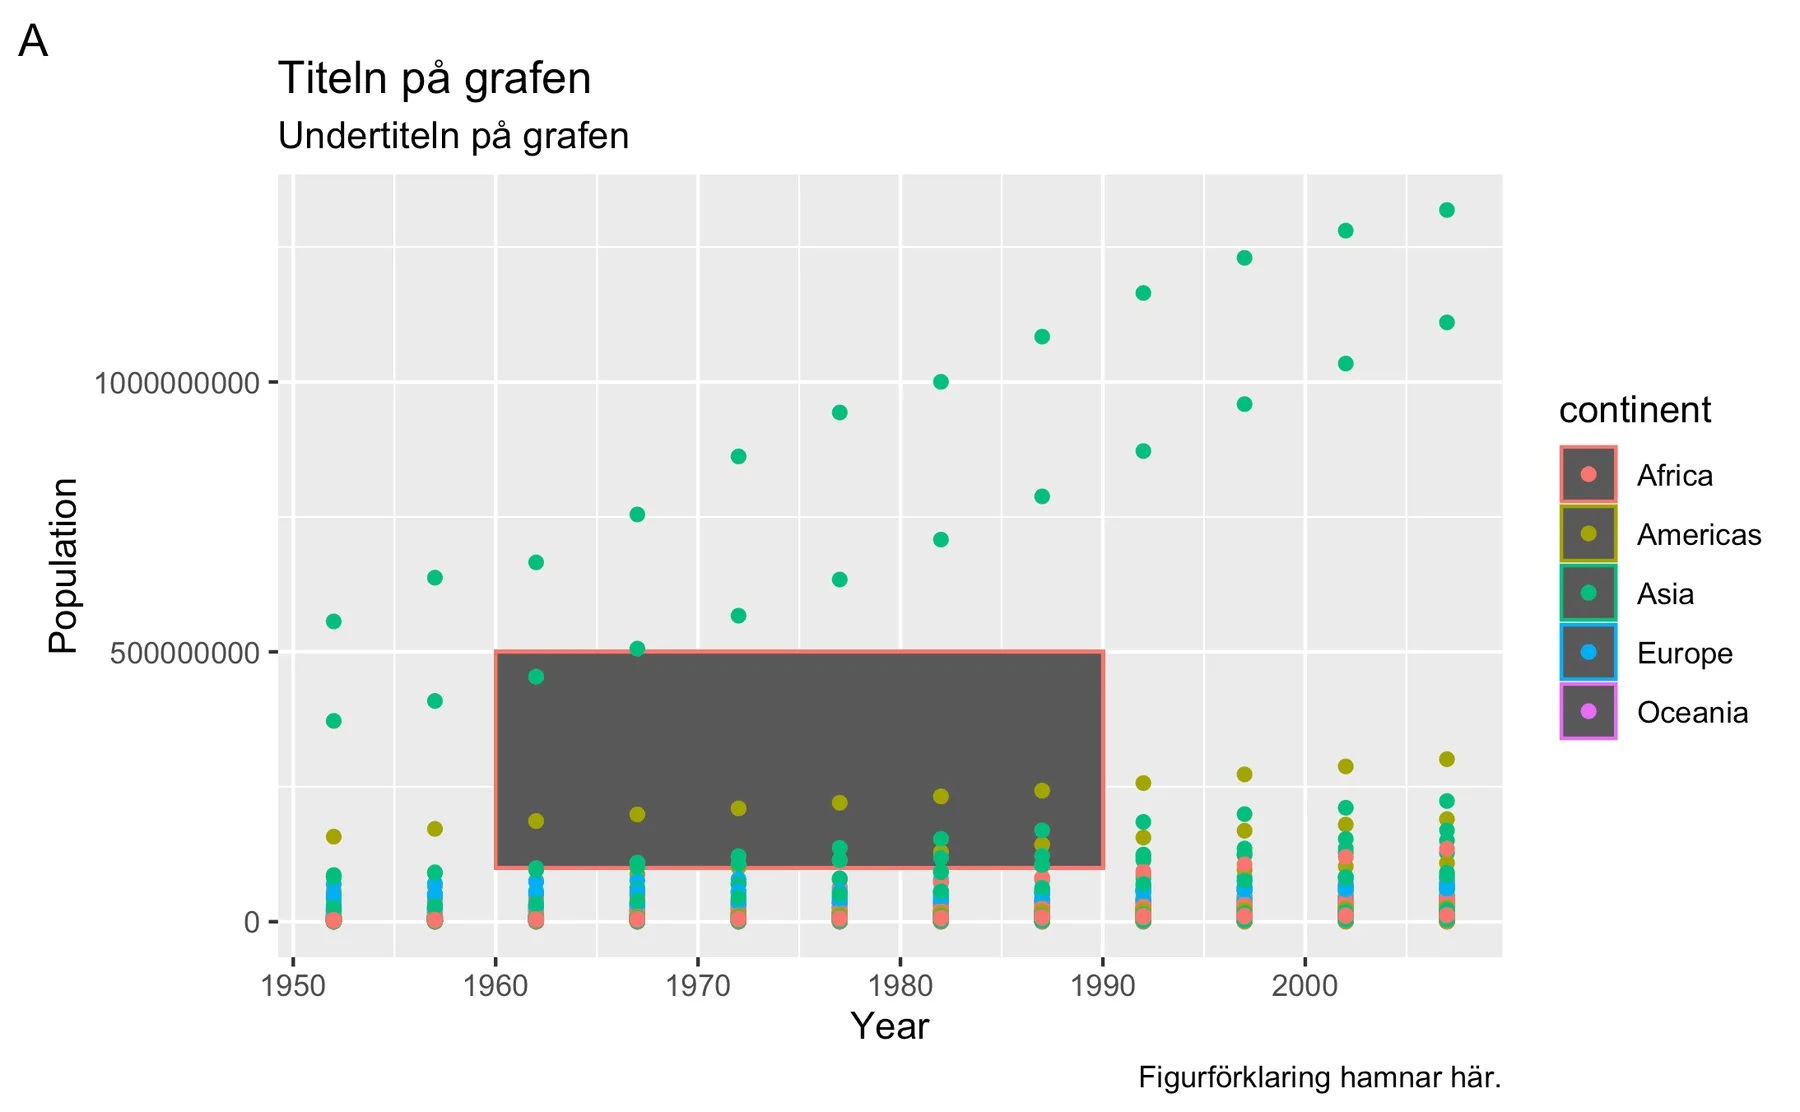
Med geom_segment() kan du markera särskilt intressanta punkter. Funktionen har argumentet arrow för att rita pilar.
Notera att y-axeln uppvisar ett mycket stort intervall med stor skillnad mellan datapunkterna. I dessa scenarion är det fördelaktigt att logaritmera variabeln. Vi logaritmerar y-axeln genom att addera funktionen scale_y_log10() som logaritmerar alla y-värden. Det innebär att du kan göra matematiska beräkningar i samband med visualiseringen (datakällan ändras inte).
ggplot(data=gapminder, aes(x=year,
                           y=pop,
                           color=continent)) +
  geom_point() +
  # NYTT
  scale_y_log10()