Överlevnadsfunktion (survival function) och hazard function
Föregående kapitel (Överlevnadsanalys) är en förutsättning för att förstå detta kapitel.
Överlevnad (survival time) är en kontinuerlig variabel som kan beskrivas med två enkla funktioner:
- – Överlevnadsfunktionen (survival function) är sannolikheten för att en person skall vara vid liv efter tidpunkt t.
- – Hazardfunktionen (hazard function) beskriver den omedelbara risken för att händelsen (event) skall inträffa vid tidpunkt t, förutsatt att personen överlevt fram till tidpunkt t.
Alla kontinuerliga variabler (inklusive survival time) kan beskrivas med en kumulativ fördelningsfunktion (cumulative distribution function, CDF). Dessa funktioner är sannolikhetsfördelningar som definieras som följer:
Funktionen beskriver sannolikheten för att är mindre eller lika med . Överlevnadstid, , har också en kumulativ fördelningsfunktion:
Denna funktion beskriver sannolikheten för att eventet inträffar på eller innan tidpunkt , men inte senare än . Vårt mål är dock att skatta , vilket är sannolikheten för att individen överlevt tidpunkt (dvs inte drabbats av händelsen vid tidpunkt ). är alltså sannolikheten för att överleva tidpunkt :
har en trappstegsliknande form, vilket framgår av nedanstående graf (Kaplan-Meier kurva). Grafen beskriver hur sannolikheten för överlevnad minskar under tidens gång. Plustecknen (+) på grafen indikerar tidpunkter då personer censurerats. påverkas inte av censureringar. minskar endast när en eller flera individer drabbas av eventet.
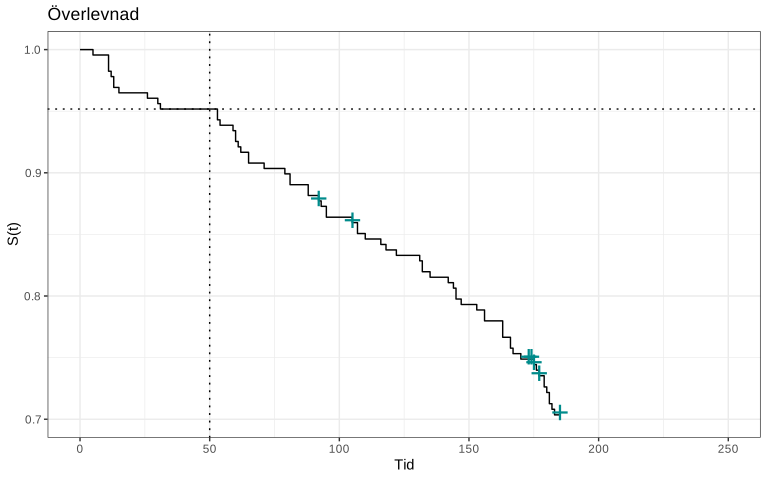
I ovanstående graf är värdet på 0.952 vid , vilket innebär att sannolikheten att överleva minst 50 dagar är 95.2%, och 4.8% har drabbats vid . Medianöverlevnaden är tidpunkten då 50% i populationen har drabbats av eventet, dvs .
Kaplan-Meier estimator (Product Limit Estimator)
Det är alltid viktigt att visualisera överlevnaden med en graf eftersom det förtäljer hur överlevnadsprocessen utvecklas över tid. Den vanligaste metoden för att presentera är med hjälp av Kaplan-Meier estimatorn (Kaplan-Meier-kurva, Product Limit Estimator), vilken demonstrerats i figuren ovan.
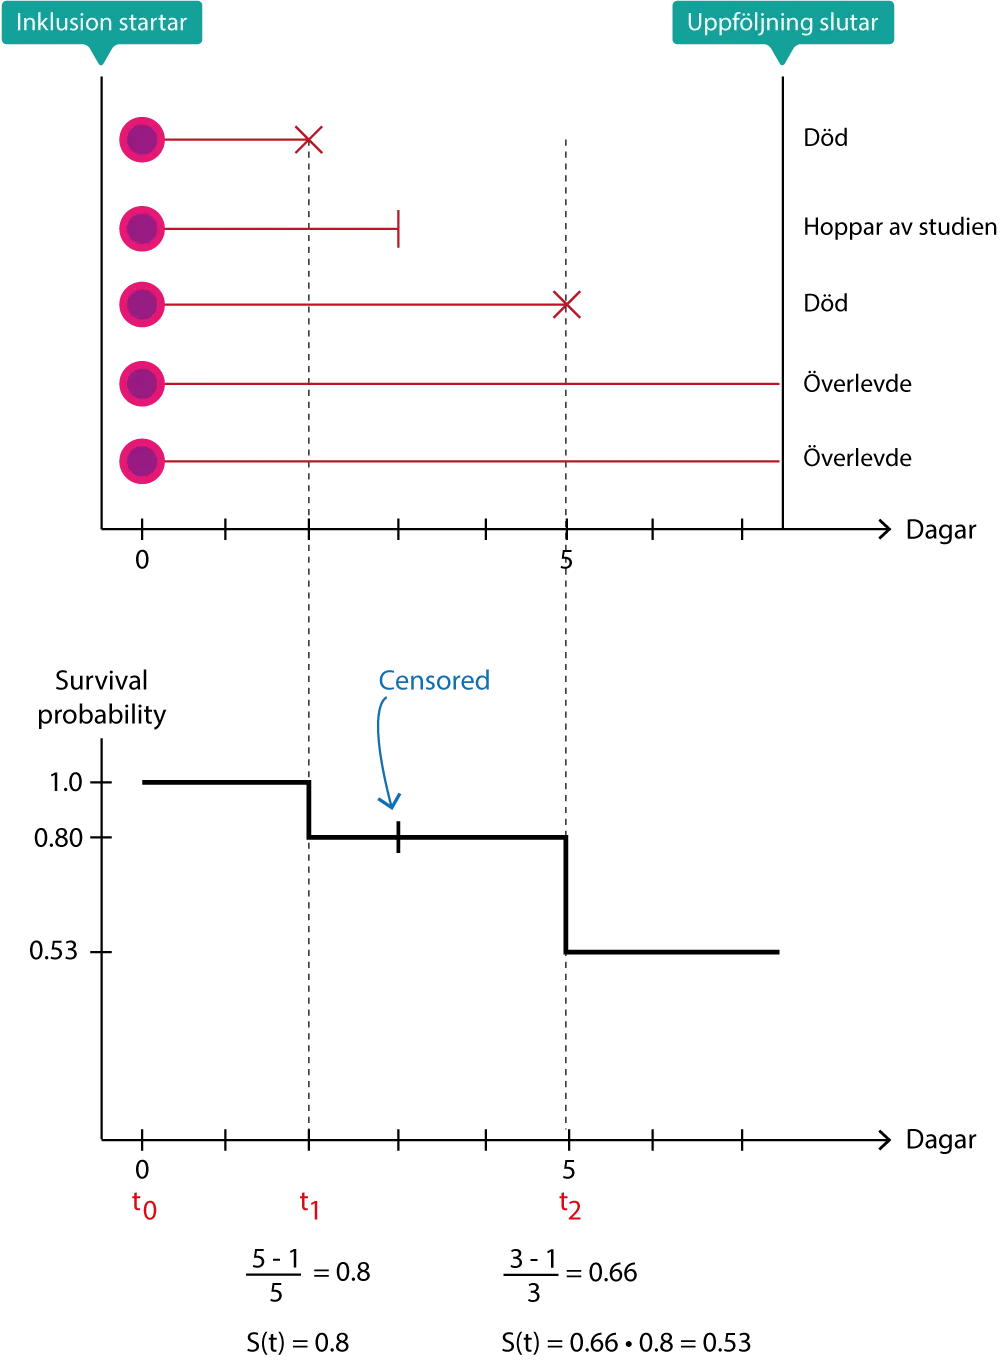
För att skapa en Kaplan-Meier kurva måste survival time (uppföljningstiden) brytas ner till interavaller. Varje intervall börjar när ett event inträffar. Alla tidpunkter då händelser inträffar (event times) rangordnas, från första till sista event. Vid inträffar den första händelsen, vid inträffar den andra händelsen, vid inträffar den tredje händelsen och så vidare. Studien börjar vid och då har ännu ingen händelse inträffat. Vid är , vilket innebär att sannolikheten för överlevnad är 100%.
För att beräkna vid så görs följande beräkning:
= antal patienter observerade i början av
= antal events vid
Detta är andelen patienter som överlever efter , bland de patienter som överlevde fram till . För att beräkna sannolikheten för att överleva efter , förutsatt att man klarar sig fram till dess görs beräkningen i två steg:
är produkten av sannolikheten att överleva fram till , vilket blir:
Detta är illustrerat i nedanstående figur.
| Tidpunk (x) | Antal vid risk | Antal events | Antal censurerade | Överlevnad (y) |
|---|---|---|---|---|
| 0 | 228 | 0 | 0 | 1.00000000 |
| 5 | 228 | 1 | 0 | 0.99561404 |
| 11 | 227 | 3 | 0 | 0.98245614 |
| 12 | 224 | 1 | 0 | 0.97807018 |
| 13 | 223 | 2 | 0 | 0.96929825 |
| 15 | 221 | 1 | 0 | 0.96491228 |
| 26 | 220 | 1 | 0 | 0.96052632 |
| 30 | 219 | 1 | 0 | 0.95614035 |
| 31 | 218 | 1 | 0 | 0.95175439 |
| 53 | 217 | 2 | 0 | 0.94298246 |
| 54 | 215 | 1 | 0 | 0.93859649 |
| 59 | 214 | 1 | 0 | 0.93421053 |
| 60 | 213 | 2 | 0 | 0.92543860 |
| 61 | 211 | 1 | 0 | 0.92105263 |
| 62 | 210 | 1 | 0 | 0.91666667 |
| 65 | 209 | 2 | 0 | 0.90789474 |
| 71 | 207 | 1 | 0 | 0.90350877 |
Survival probability är på Kaplan-Meier kurvan. Detta är således andelen som fortfarande är vid liv vid varje tidpunkt. Kurvan går gradvis nedåt allteftersom personer drabbas av eventet. Kaplan-Meier kurvan når endast om alla deltagare drabbas av eventet. Medianöverlevnaden är helt enkelt andelen som lever vid .
Hypotestest och överlevnadsanalys: log-rank test
Testa skillnad mellan överlevnadskurvor
I följande figur jämförs överlevnaden mellan män och kvinnor.
21.7.1 R kod för ovanstående Kaplan-Meier-kurva
install.packages("survival")
library(survival)
install.packages("survminer")
library(survminer)

## Ladda exempeldata
data(colon)

## Inspektera första 10 raderna
head(colon, 10)
id study rx sex age obstruct perfor adhere nodes status differ extent surg node4 time etype
1 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 1521 2
2 1 1 Lev+5FU 1 43 0 0 0 5 1 2 3 0 1 968 1
3 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 2
4 2 1 Lev+5FU 1 63 0 0 0 1 0 2 3 0 0 3087 1
5 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 963 2
6 3 1 Obs 0 71 0 0 1 7 1 2 2 0 1 542 1
7 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 293 2
8 4 1 Lev+5FU 0 66 1 0 0 6 1 2 3 1 1 245 1
9 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 659 2
10 5 1 Obs 1 69 0 0 0 22 1 2 3 1 1 523 1Överlevnadsfunktionen genereras med funktionerna survfit() och Surv(). I Surv() är första argumentet överlevnadstid (time) och andra argumentet är event-variabeln. För event-variabeln kan vi specificera vilken nivå som indikerar att händelsen inträffat. Detta gör vi nedan genom att specificera status==1. Med argumentet pval = TRUE begär vi hypotestestning med log-rank test. Detta test beräknar sannolikheten för att nollhypotesen ( stämmer (nollhypotesen postulerar att det inte finns någon skillnad i överlevnad. Om p-värdet som genereras med log-rank test är < 0.05 förkastats . I detta fall jämförs män med kvinnor genom att inkludera variabeln sex som stratum:
## Skapa survfit-objekt. I detta objektet skapas överlevnadsfunktionen
fit <- survfit(Surv(time, status==1) ~ sex, data = lung)

## Rita Kaplan-Meier-kurva
ggsurvplot(fit, data = lung, risk.table = TRUE, pval = TRUE)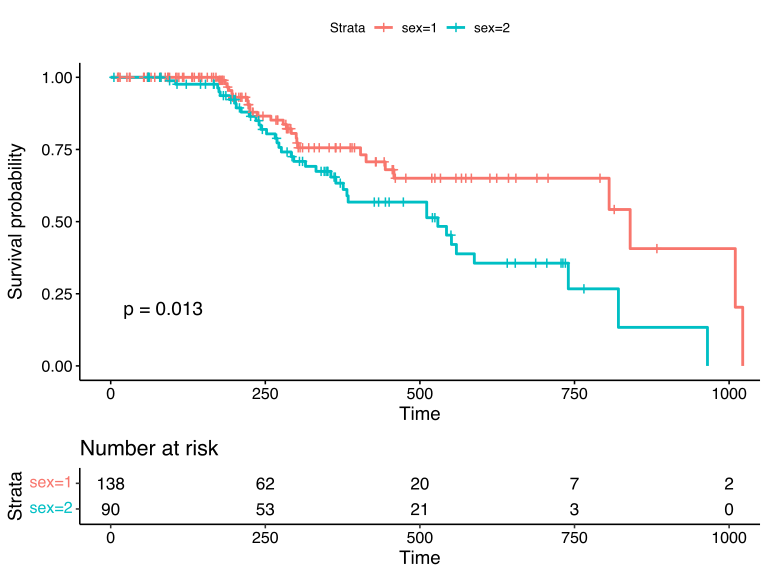
Som framgår ovan är kurvorna separerade, vilket innebär att överlevnaden skiljer sig för män (sex=2) och kvinnor (sex=1). Vid varje tidpunkt är högre för kvinnor. Det innebär att överlevnaden är bättre för kvinnor och det kan alltså bedömas visuellt. P-värdet är 0.013, vilket också indikerar att skillnaden är statistiskt signifikant. P-värdet är beräkant med log-rank test.
Principen för log-rank test följer principen för hypotestestning. Man utgår från nollhypotesen () som postulerar att det inte finns någon skillnad mellan grupperna och därefter beräknas en sannolikhet (p-värde) för att nollhypotesen stämmer. Om sannolikheten är <0.05 så förkastas nollhypotesen. Log-rank test kan användas för att jämföra två eller flera överlevnadskurvor.
Således kan Kaplan-Meier-kurvan användas för att studera överlevnad. Detta kan göras i hela populationen eller subgrupper (t ex män och kvinnor). Man kan dock inte justera för kovariater i en Kaplan-Meier-beräkning; detta kräver regressionsanalys, varav den vanligaste metoden är Cox regression som diskuteras i nästa kapitel.