Regression
Med regression undersöker man sambandet (associationen) mellan två eller fler variabler. I en regressionsanalys prediceras en variabel () av minst en prediktor (). Rent terminologiskt sägs vara beroende av ; är därför den beroende variabel och är oberoende variabel.
| Uppgift i modellen | Synonym | |
|---|---|---|
| Y | Variabeln som skall prediceras | Beroende variabel, dependent variable, outcome, utfall, utfallsmått, label, target |
| X | Används för att prediera Y | Prediktor, predictor, feature, kovariat, covariate |
Ponera att vi undersöker sambandet mellan BMI (body mass index) och blodsocker. Med regression kan vi använda den ena variabeln för att predicera värdet på den andra. I detta fall används BMI för att predicera blodsocker. BMI är således oberoende (prediktor) och glukos är beroende (outcome).
Vi kommer illustrera linjär regression med data från Pimaindianer, vilket har mycket hög risk för diabetes. Data från Pimaindianer finns i paketet mlbench. Installera mlbench och aktivera paketet, samt data med Pimaindianer med följande kommando:
library(mlbench)
data(PimaIndiansDiabetes)

## Graf med sambandet mellan mass och glucose
ggplot(data=PimaIndiansDiabetes,
       aes(x=mass, y=glucose, color=diabetes)) +
  geom_point() +
  geom_smooth()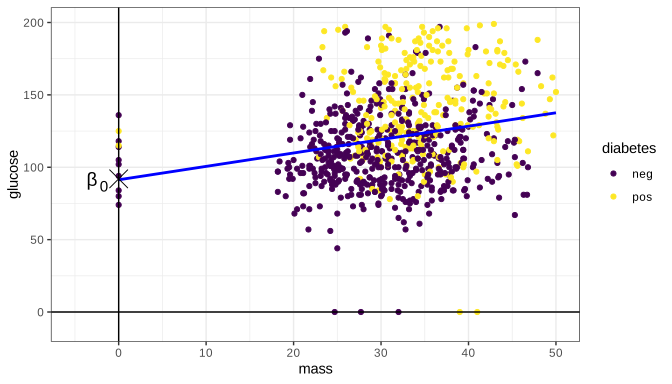
Figuren ovan visar hur BMI (mass) är associerad med blodsocker (glucose). I grafen ses en rak blå linje som utgör regressionslinjen för mass. Sambandet mellan mass och glucose kan beskrivas med en enkel formel.
- är interceptet, vilket är punkten där regressionslinjen skär Y-axeln (se figur ovan).
- är koefficienten för
mass, vilket innebär att det är värdet på regressionslinjens lutning. - är skillnaden mellan modellens predicerade värde på och det observerade värdet på . Detta är alltså modellens felprecision (error).
Sammanfattningsvis är detta en modell som predicerar med hjälp av en regressionslinje vars lutning är . Interceptet () intresserar oss mycket sällan. Modellens felprecision () är ett mått på hur bra modellen är.
Målet är att skapa en regressionslinje vars lutning anpassas så att den representerar sambandet mellan och . Linjens lutning beror på sambandet mellan mass och glucose. Lutningen för mass kallas även koefficienten för mass. Om glucose stiger med stigande mass, så kommer regressionslinjen ha en positiv lutning. I figuren ovan ses att linjen har en positiv lutning och därför är koefficienten för mass posiitv.
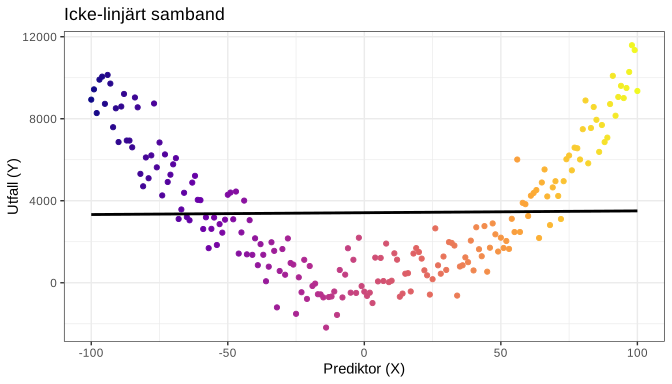
Notera att relationen mellan och måste vara linjär för att den linjära modellen skall kunna användas. Om sambandet inte är linjärt kan den linjära modellen bli missvisande. Här följer ett exempel på ett icke-linjärt samband mellan och . Den beräknade regressionslinjen lyckas inte fånga sambandet mellan och .
Vi fortsätter genom att skapa en linjär regressionsmodell i R. Detta görs med funktionen lm() som finns i base R (du behöver inte installera något paket).
modell <- lm(glucose ~ mass, data=PimaIndiansDiabetes)

summary(modell)Call:
lm(formula = glucose ~ mass, data = PimaIndiansDiabetes)
Residuals:
Min 1Q Median 3Q Max
-128.970 -20.756 -3.705 19.509 81.568
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 92.2129 4.7083 19.585 < 0.0000000000000002 ***
mass 0.8965 0.1429 6.274 0.000000000589 ***
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 31.2 on 766 degrees of freedom
Multiple R-squared: 0.04887, Adjusted R-squared: 0.04763
F-statistic: 39.36 on 1 and 766 DF, p-value: 0.0000000005891Av ovangående resultat framgår följande:
- Interceptet är 92.2 vilket innebär att regressionslinjen skär Y-axeln på Y=92.2, och det förefaller stämma med den grafiska undersökningen.
- , dvs koefficienten för mass är 0.8965. Det innebär att om
massökas med 1 enhet, ökarglucosemed 0.8965 enheter.
Beräkning av regressionslinjen
Fundamentalt för regressionsanalys är beräkning av regressionslinjen. Den vanligaste metoden är least-squares method (på svenska metod med kvadratsummor). Least-squares kan även kallas för ordinary least-squares. Metoden skapar en linje som minimerar summan av error. I nedanstående figur har samma data som ovan (Pimaindianerna) förstorats i intervallet 50 till 150 på x-axeln och y-axeln för att tydliggöra vad kvadratsummor är. I nedanstående figur ses även en regressionslinje.
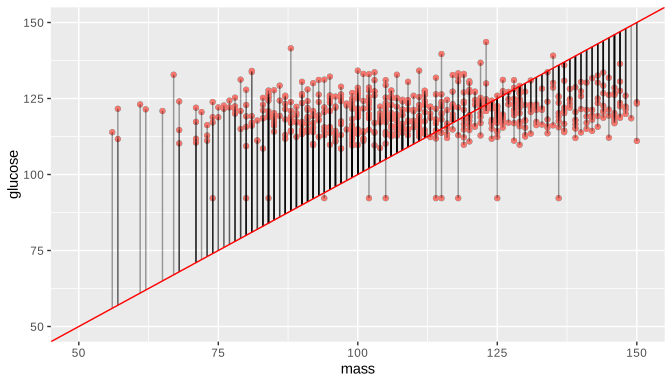
Least-squares syftar till att skapa en regressionslinje som minimerar summan av alla observationers error. I figuren ovan framgår att regressionslinjens avstånd till punkterna varierar mycket. I intervallet 100 till 140 på x-axeln är linjen nära punkterna (error blir litet), men utanför detta intervallet är linjen längre ifrån punkterna (error blir större). Metoden med kvadratsummor går ut på att minimera sammanlagd (total) error. Linjen tippas fram och tillbaka tills lutningen minimerar summan av alla error. Innan man adderar alla error så kvadreras error; syftet med detta är att alla negativa error (de som befinner sig under linjen) skall bli positiva värden. Summan av alla kvadrerade error kallas RSS (Residual Sum of Squares). Den linjära modellens uppgift är således att hitta och som minimerar RSS. Formeln för RSS är som följer:
Coefficient of determination: R2
För att skatta styrkan på sambandet mellan och så kan man använda coefficient of determination, även kallat . Detta värde går from 0 till 1. Om är 0 så finns inget samband och om är 1 så finns ett perfekt samband, vilket innebär att kan förklara hela variationen i .
Antaganden för regression med least-squares method
Följande antaganden krävs för att least-square skall kunna användas:
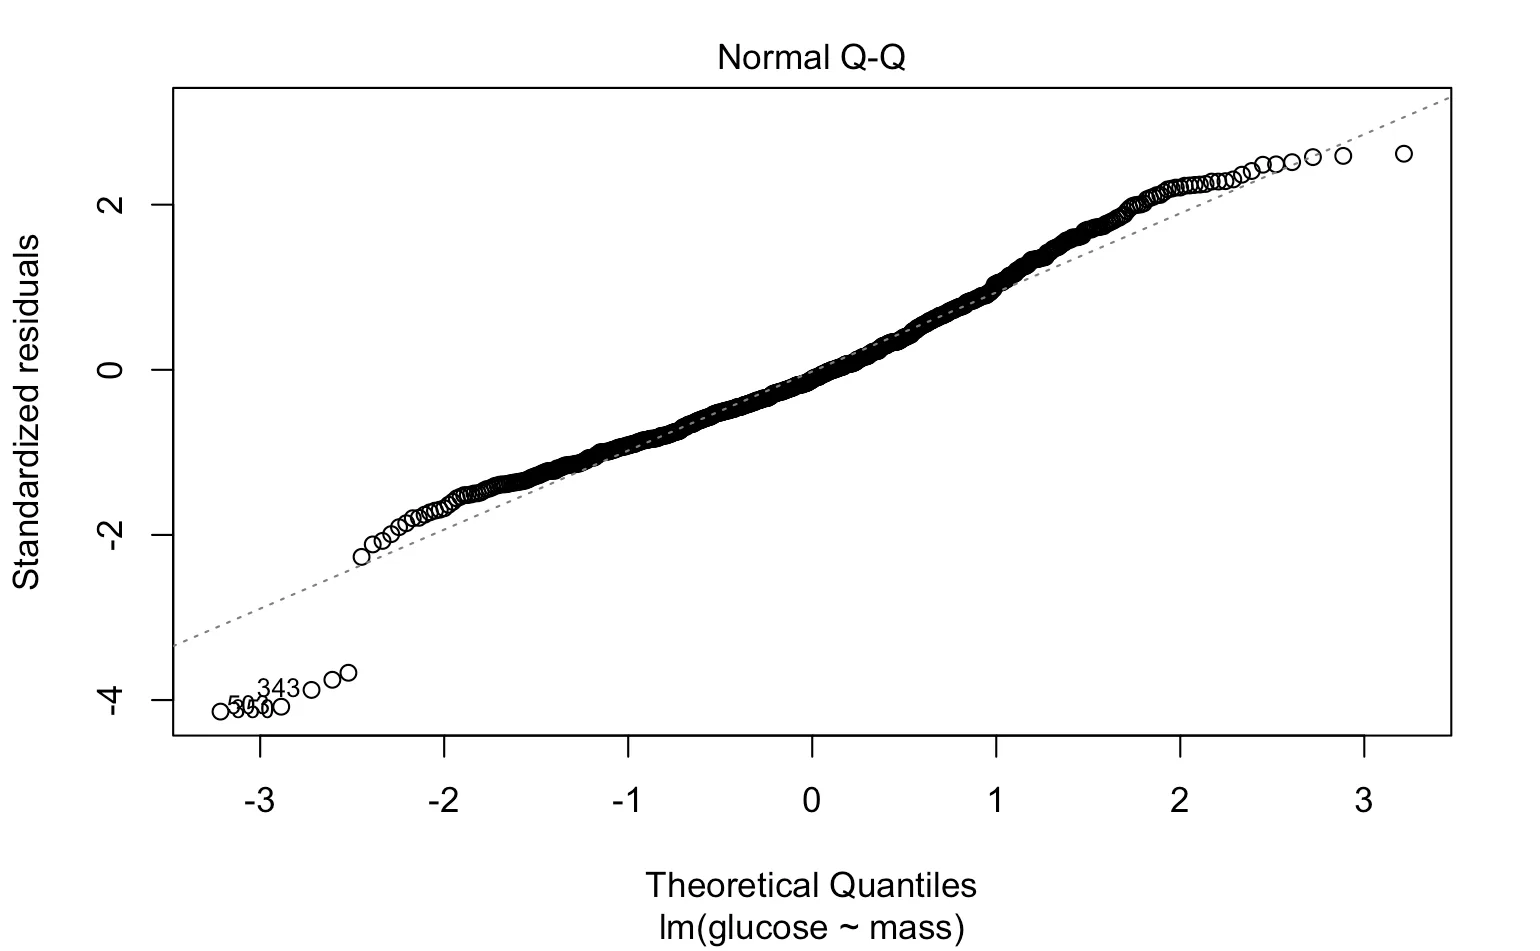
- Residualerna skall vara normalfördelade med medelvärdet 0. Detta kan kontrolleras med en så kallad quantile-quantile plot. I en quantile-quantile plot skall en rak linje ses om antagandet är tillfredsställt.
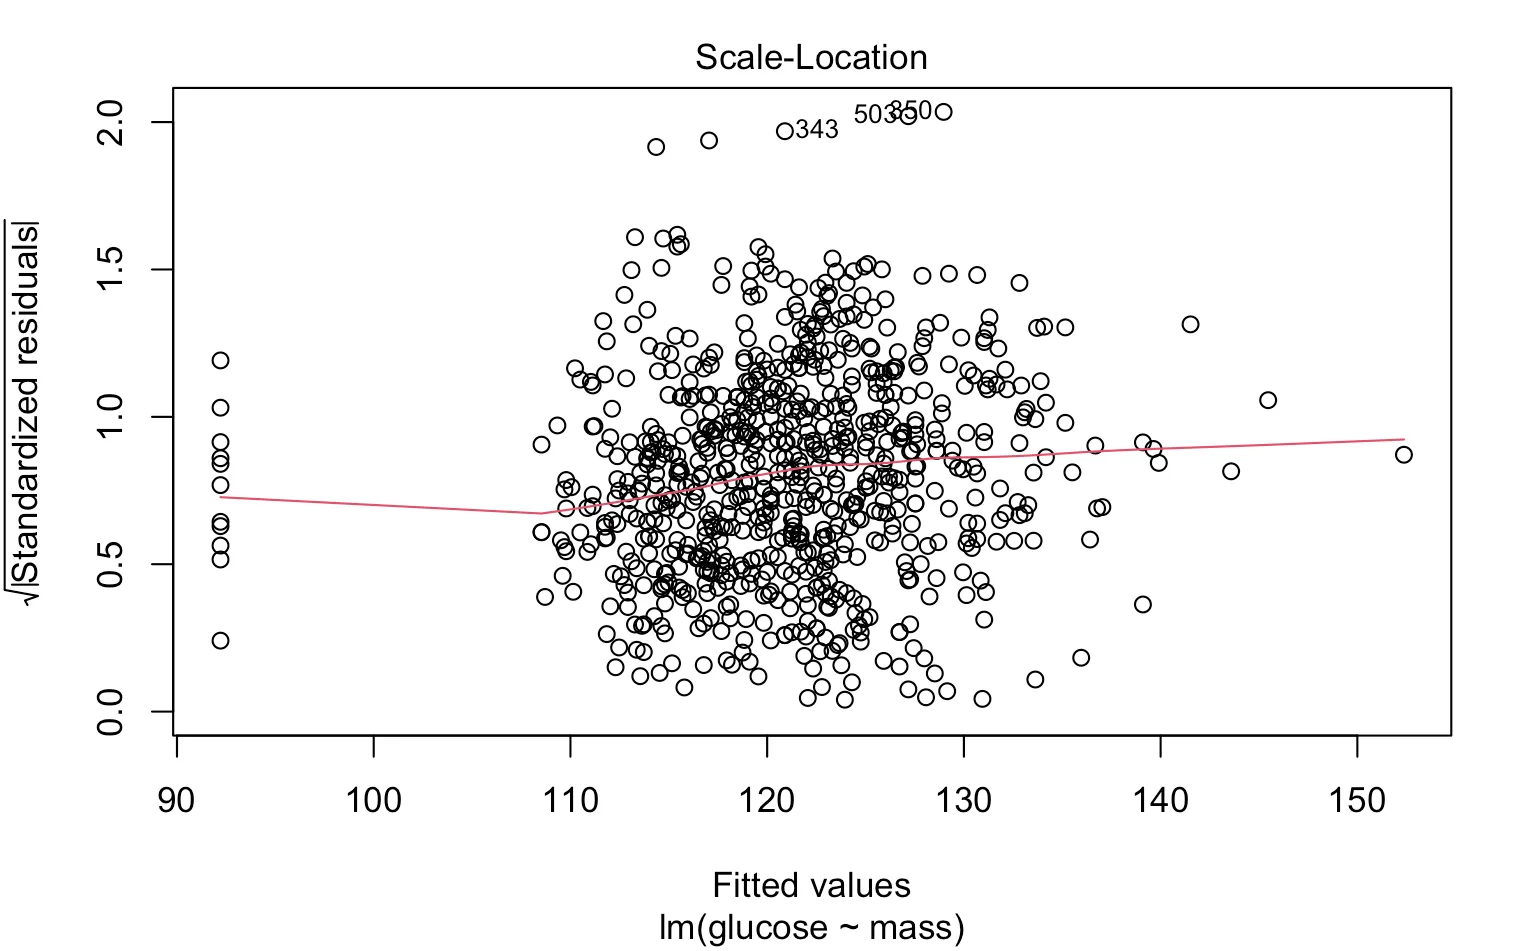
- Residualerna skall ha konstant varians. Detta kan kontrolleras genom en scatterplot med estimerade residualer mot fitted values. Scatterplot skall visa ett moln utan något samband mellan värdena.
- Residualerna skall vara oberoende av varandra. Detta är sällan ett problem såvida inte samma person/cell/bakterie/enhet/etc ingår flera gånger i studiepopulationen. Om samma person ingår flera gånger i studiepopulationen (exempelvis genom upprepade mätningar av BMI och glukos) så är de observationernas residualer beroende av varandra.
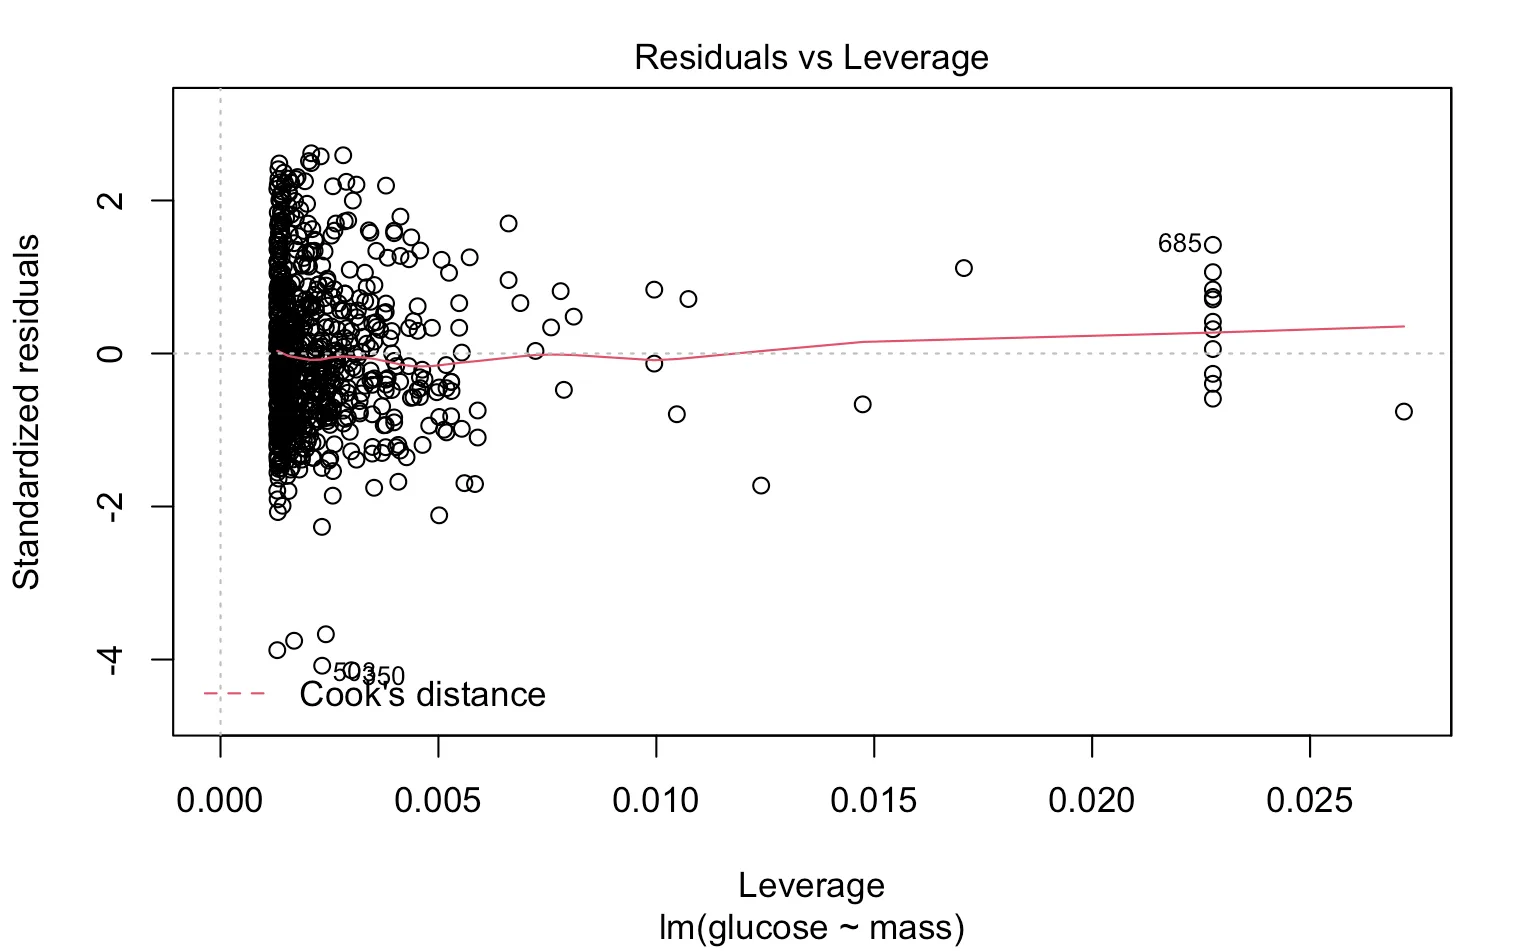
Punkt (1) och (2) kan undersökas enkelt i R genom följande kommando, som returnerar alla nödvändiga grafer:
plot(modell)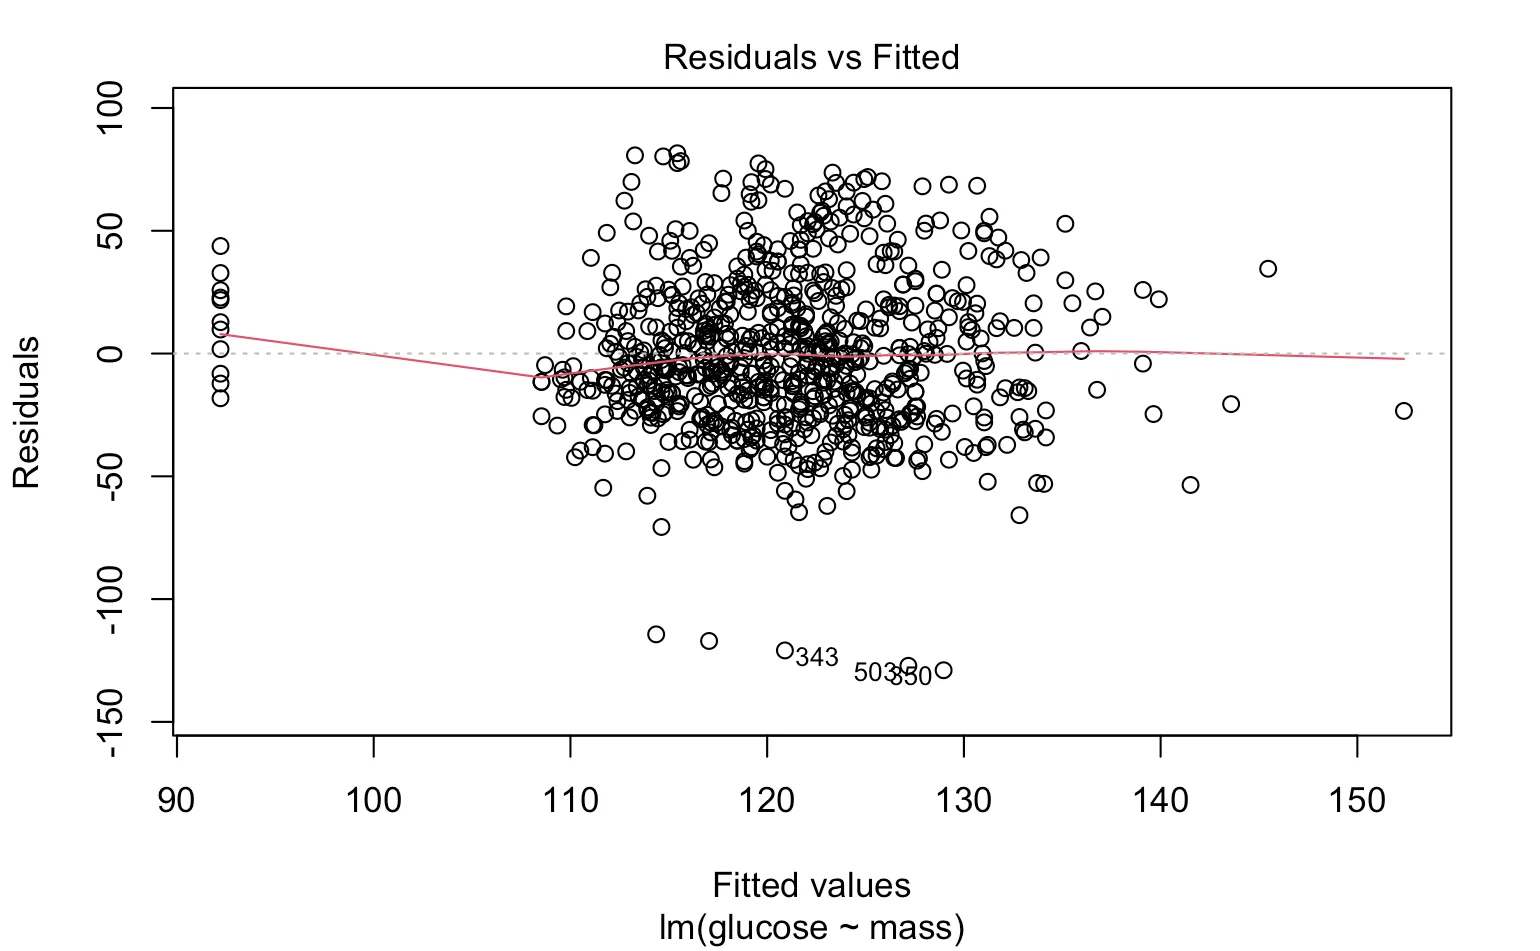
Prediktion med regression
Regressionsmodellen kan användas för prediktion. Det innebär att vi kan gissa värdet på Y för ett givet värde på X. Det kan exempelvis var av intresse att förutsäga vad glucose kommer vara vid ett givet mass. För att göra detta skapar vi nu en ny modell med specifikationen glucose ~ . vilket betyder att vi modellerar glucose mot alla andra variabler. Därefter använder vi predict() med modellobjektet (modell_2) och specificerar vilka data vi vill testa modellen på. I detta fall testar vi på samma data som vi tränade på, vilket inte rekommenderas. Vi sparar det predicerade värdet som en ny kolumn (Predicted_Glucose) i samma dataframe. Allra sist skriver vi ut första 10 raderna med observerade värden och predicerade värden.
modell_2 <- lm(glucose ~ ., data=PimaIndiansDiabetes)

PimaIndiansDiabetes$Predicted_Glucose <- predict(modell_2, newdata=PimaIndiansDiabetes)

select(PimaIndiansDiabetes, glucose, Predicted_Glucose) %>%
  slice(1:10)
glucose Predicted_Glucose
1 148 134.03797
2 85 100.53489
3 183 130.46052
4 89 106.04599
5 137 145.69693
6 116 106.94069
7 78 128.57557
8 115 98.26398
9 197 181.40914
10 125 136.97599Multipel regression
Om vi vill undersöka hur BMI (mass) samvarierar med glukos (glucose) och även beakta ålder, så använder vi multipel regression. Definitionen av multipel regression är helt enkelt regression med minst 2 prediktorer. Multipel regression följer samma principer som den linjära regressionen som diskuterats hittills. Metoden least-squares används som vanligt men i detta fall anpassas inte en regressionslinje utan istället ett regressionsplan genom datapunkterna. Detta plan har ett tredimensionellt utseende som illustreras nedan i samma data. Den andra prediktorn är pressure (blodtryck).
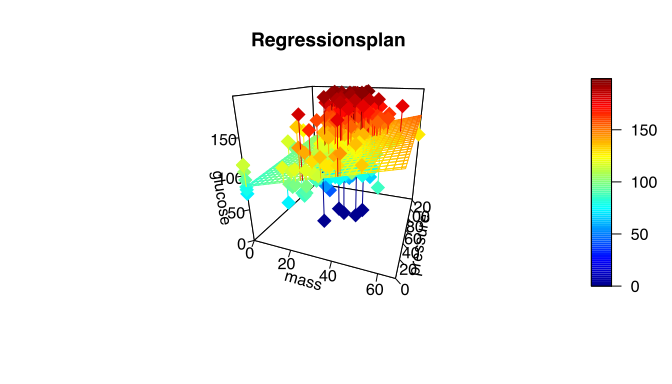
Koden för regressionsmodellen blir:
modell_2 <- lm(glucose ~ mass + pressure, data=PimaIndiansDiabetes)
summary(modell_2)Call:
lm(formula = glucose ~ mass + pressure, data = PimaIndiansDiabetes)
Residuals:
Min 1Q Median 3Q Max
-129.725 -20.893 -3.277 19.206 80.092
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 84.60294 5.48135 15.435 < 0.0000000000000002 ***
mass 0.78442 0.14834 5.288 0.000000161 ***
pressure 0.16201 0.06042 2.681 0.00749 **
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
Residual standard error: 31.08 on 765 degrees of freedom
Multiple R-squared: 0.05773, Adjusted R-squared: 0.05526
F-statistic: 23.43 on 2 and 765 DF, p-value: 0.0000000001326Tolkning av koefficienterna är som följer.
- När
massstiger med 1 enhet ökarglucosemed 0.78442 enheter. Denna effekt är justerad för pressure. - När
pressurestiger 1 enhet ökarglucosemed 0.16201 enheter. Denna effekt är justerad förmass.